
QWeb © Research
 LinkedIn-Artikel: Vom Parallelrechner zum Parallel-Quantum-Computing und dem 'QWeb ©'
Vom Parallelrechner zum Parallel-Quantum-Computing und dem 'QWeb ©'
(From parallel computing to parallel quantum computing – and the “QWeb ©")
So wie der PC und das Internet einst die Vorherrschaft der Mainframe-Ära in Frage stellten, ohne sie jedoch überflüssig zu machen, wird das fehlertolerante verteilte Quanten-computing (DQC) das heutige, auf Hyperscaler ausgerichtete Modell herausfordern.
Die Idee dahinter: Anstatt einen immer größeren, zentralisierten Quantencomputer zu bauen, verbindet man viele kleinere Quantenprozessoren über quantenmechanische und klassische Kanäle zu einem skalierbaren System. Je größer ein einzelner Chip wird, desto mehr gerät er in Konflikt mit sich selbst – Qubits interferieren miteinander, und der Kühl- und Verdrahtungsaufwand steigt exponentiell an. Ein Netzwerk vermeidet dies: Skalierung in die Breite statt in die Höhe.
Die zentrale Herausforderung: Wie korrigiert man Fehler, wenn eine Berechnung über mehrere verrauschte, miteinander verbundene Module läuft? Jüngste Simulationen zeigen, dass die Fehlerraten in einigen Fällen um eine Größenordnung sinken, und im Jahr 2025 lief erstmals ein verteilter Quantenalgorithmus über photonisch verbundene Module. Das macht DQC zu einem der vielversprechendsten Wege hin zum fehlertoleranten Quanten-computing.
Genau diesen Wandel fasse ich mit dem Begriff “QWeb ©" zusammen:
Peripherie statt Zentrum, Netzwerk statt Monolith – eine Zukunft, in der Rechenleistung dezentral entsteht und nicht nur in den Rechenzentren einer Handvoll Hyperscaler.
Die Zukunft rechnet verteilt.
#QuantumComputing
~ ~ ~
Distributed Quantum Computing (Parallel-Quantum-Computing) auf Wikipedia:
Originalliteratur:
- Main et al. (2025): Distributed quantum computing across an optical network link – Nature 638, 383–388
- University of Oxford (2025): First distributed quantum algorithm brings quantum supercomputers closer – Pressemitteilung
Ich habe damit als erster weltweit (!) den Begriff "QWeb ©" geprägt und postuliert und am 1. Juli 2026 auf LinkedIn erstmals veröffentlicht und über das Internet Archive und qweb-quantum.com dokumentiert, um damit die These zu bezeichnen, dass fehlertolerantes ver-teiltes Quantencomputing die heutigen Hyperscaler-Strukturen relativieren wird – ähnlich wie einst PC und Internet die Mainframes zurückgedrängt haben.
Der LinkedIn-Artikel ist in englischer und deutscher Sprache verfasst.
Mathematische Grundlagen (Mathematical Foundations)
 Was ein Qubit tatsächlich ist
(im Original: „What a Qubit Actually Is")
Niemand würde heute erklären, wie ein Rechner funktioniert, indem er bei der Physik des NPN-Übergangs im Transistor beginnt. Das ist vollkommen richtig — und der falsche Einstieg. Stattdessen greift man zur booleschen Algebra, nicht weil die Halbleiterphysik aufgehört hätte zu gelten, sondern weil sie aufgehört hat, die Ebene zu sein, auf der sich Nützliches sagen lässt.
Beim Quantencomputing besteht dasselbe Problem, nur ist es dort ungelöst. Die Superposition ist der Halbleiterübergang dieses Themas, und fast jede Erklärung beginnt mit ihr.
Dieser Beitrag versucht eine andere Reihenfolge.
Der Satz, der in die Irre führt. „Ein klassisches Bit ist 0 oder 1, ein Qubit beides zugleich." Der Satz ist eigentlich nicht falsch, aber er pflanzt ein Bild ein — eine kleine Schachtel mit zwei Werten darin. Und von dort ist es nur ein kurzer Weg zu „ein Quantenrechner probiert alle Antworten gleichzeitig durch", wo die meisten populären Darstellungen enden.
Es gibt einen Test, der die Sache entscheidet: Hielte ein Qubit wirklich beide Werte, und könnte man sie auslesen, wäre Quantencomputing trivial. Aufgabe laden, alle Antworten ablesen, fertig. Die gesamte Schwierigkeit des Feldes — jeder Algorithmus, jedes kunstvolle Stück Interferenztechnik — besteht darin, dass man es eben nicht kann. Das Bild ist also nicht unvollständig, sondern falsch.
Die richtige Ebene. Ein Qubit hält einen Zustand, und dieser ist bestimmt. Er ist nicht unentschieden, nicht verschmiert, nicht zweierlei. Der Unterschied zum Bit liegt nicht in der Menge, sondern in der Art: Der Zustand ist eine Richtung, kein Wert.
Messen heißt dann, eine Achse zu wählen und entlang ihr zu fragen. Fragt man entlang der Richtung, in die der Zustand zeigt, ist die Antwort sicher. Fragt man quer dazu, bekommt man eine faire Münze. Je schräger die Frage, desto unsicherer die Antwort.
Dabei geschieht mit dem Zustand Verschiedenes. Entlang seiner eigenen Richtung gemessen bleibt er unverändert — man kann beliebig oft fragen und bekommt stets dasselbe. Quer dazu gemessen wird er dagegen zerstört: Die Messung zwingt das Qubit auf eine der beiden Achsenrichtungen, und dort bleibt es. Die faire Münze zeigt sich also nur beim ersten Mal. Um die Verteilung überhaupt zu sehen, braucht man viele gleich präparierte Qubits, jedes einmal gefragt — nicht eines mehrfach.
Daraus folgt der Satz, der das häufigste Missverständnis auflöst: Die Zufälligkeit gehört zur Frage, nicht zum Qubit.
Und woher kommt dann die Leistung? Nicht daher, dass ein Qubit viele Werte hielte. Sondern daher, dass sich die Richtungen mehrerer Qubits auf eine Weise verbinden lassen, die kein Satz unabhängiger Bits nachbildet — und dass sich die falschen Möglichkeiten gegenseitig auslöschen lassen, bevor überhaupt gemessen wird. Das ist Interferenz, und das ist der eigentliche Mechanismus.
Weniger aufregend als „probiert alles gleichzeitig", aber erheblich brauchbarer: Ein Quantenrechner erkundet nicht alle Möglichkeiten. Er sorgt dafür, dass die falschen sich aufheben.
Der Beitrag kommt übrigens durch sieben Abschnitte, ohne das Wort Superposition ein einziges Mal zu verwenden. Das war die Absicht.
→ Zum Artikel: What a Qubit Actually Is
 Was Entropie tatsächlich misst
(im Original: „What Entropy Actually Measures")
Die Entropie schleppt für eine Größe mit einzeiliger Definition erstaunlich viel Gepäck mit sich. Sie kommt an in Begleitung von Wärmekraftmaschinen, dem Zeitpfeil, dem Wärmetod des Universums und einem vagen Gefühl, dass die Dinge zerfallen. Nichts davon hilft, wenn sie in einer Formel über Qubits auftaucht.
Also nicht Unordnung, sondern Unwissen. Ein gemischtes Kartenspiel ist in keinem Sinn ungeordnet, den ein Physiker verteidigen würde — jede Anordnung ist so gültig wie jede andere. Was das gemischte Spiel ist, ist einem unbekannt. Und genau diese Größe misst die Entropie.
Warum die Formel so aussieht, wie sie aussieht. Das Minuszeichen und der Logarithmus wirken willkürlich, bis man fragt, was ein solches Maß erfüllen müsste. Zwei Forderungen legen es beinahe fest.
Eine Gewissheit muss null zählen — und log₂1 = 0 leistet genau das. Und Information aus unabhängigen Quellen muss sich addieren, während sich Wahrscheinlichkeiten multiplizieren. Gebraucht wird also eine Funktion, die aus Multiplikation Addition macht. Es gibt nur eine.
Wohin die Bits gehen. Das ist keine Buchhaltung: Eine Quelle mit Entropie S lässt sich auf S Bit je Zeichen komprimieren und keinen Deut weiter. Tausend faire Münzwürfe brauchen tausend Bit. Tausend Würfe einer Münze, die zu 99 Prozent Kopf zeigt, passen in 81 Bit — dieselben tausend Ereignisse, ein Zwölftel des Speichers, weil die meisten vorhersagbar waren. Jedes Kompressionsprogramm lebt davon.
Und dann die Stelle, die mich beim Durchrechnen überrascht hat. Klassisch gilt: Ein Teil kann nie weniger bekannt sein als das Ganze. Weiß man genau, was im Umschlag steckt, weiß man auch, was jedes einzelne Bit darin ist. Anders geht es nicht.
Die Quantenmechanik hält sich schlicht nicht daran. Ein Bell-Paar hat die Entropie 0 — nichts daran ist unbekannt, die Beschreibung ist vollständig und exakt. Jedes einzelne Qubit darin hat die Entropie 1, also maximal, eine faire Münze.
Der Teil trägt mehr Entropie als das Ganze. Klassisch ein Widerspruch, hier schlicht das, was Verschränkung ist.
Und wohin ist die Information verschwunden? Nirgendwohin. Sie ist nicht versickert und steckt auch nicht in einer verborgenen Größe, die noch niemand gefunden hat. Sie steckt in der Paarung. Fragt man „was tut dieses Qubit?", gibt es wirklich keine Antwort — nicht weil sie verborgen wäre, sondern weil die Frage am falschen Gegenstand ansetzt. Fragt man dagegen „stimmen diese beiden überein?", ist die Antwort exakt und sicher.
Wird S auf diese Weise berechnet, für einen Teil eines größeren Systems, heißt es Verschränkungsentropie. Es misst, wie viel vom Ganzen in die Beziehung gewandert ist.
→ Zum Artikel: What Entropy Actually Measures
 Das Nockenwellen-Problem: Was ein Quantencomputer wirklich ist
(im Original: „The Camshaft Problem: What a Quantum Computer Actually Is")
Die meisten Erklärungen zum Quantencomputing beginnen mit „Ein Qubit kann 0, 1 oder beides gleichzeitig sein" — und verraten nie, wofür das eigentlich gut sein soll. Genau das ist der Nockenwellen-Fehler: eine zutreffende Aussage über den Motor, erzählt jemandem, der bloß wissen will, wann er den Wagen zur Inspektion bringen muss.
Deshalb habe ich eine andere Art von Einführung geschrieben. Sie beginnt mit der kleinsten Aufgabe, die ein Computer je zu erledigen hat — der Addition von 1 + 1 — und schaut dabei zu, wie ein Quantencomputer sich daran versucht. Das Ergebnis überrascht: Er löst sie dramatisch schlechter. Und zwar mit Absicht. Genau diese Tatsache erweist sich als der denkbar deutlichste Wegweiser dahin, wofür Quantencomputer wirklich gemacht sind.
→ Zum Artikel: https://qweb-quantum.com/blog/camshaft-problem-what-is-a-quantum-computer
 Die Mathematik hinter dem Quantencomputing
(im Original: „The Math behind Quantum Computing")
Jeder Computer, den wir je benutzt haben, beruht auf der Booleschen Algebra: zwei Werte, eine Handvoll Gatter, ein paar Verknüpfungsregeln. Daraus entsteht der Halbaddierer, daraus die Arithmetik, daraus die von-Neumann-Architektur — und schließlich die Programmiersprachen, mit denen wir diese Maschinen steuern. Bis John Backus, der Schöpfer von Fortran, in seiner Turing-Award-Vorlesung 1977 ausgerechnet jenen Stil angriff, den er selbst mitgeprägt hatte: „Can Programming Be Liberated from the von Neumann Style?"
Was aber tritt im Quantencomputer an die Stelle der Booleschen Algebra? Die Antwort ist keine Erweiterung, sondern ein Austausch: lineare Algebra über komplexen Vektorräumen. Ein Qubit ist kein Wert, sondern ein Vektor. Ein Gatter ist keine Wahrheitstabelle, sondern eine unitäre Matrix. Und Rechnen heißt: multiplizieren.
Die Präsentation führt Schritt für Schritt von der Schulmathematik zu jener Algebra, auf der ein Qubit tatsächlich läuft. Sie erklärt, was ein Tensorprodukt wirklich ist — und was es nicht ist, denn mit dem Tensor der Relativitätstheorie hat es wenig zu tun. Sie zeigt, warum n Qubits 2n Zahlen zur Beschreibung brauchen, und warum diese Exponentialfunktion keine Metapher ist, sondern schlicht die Dimension des Zustandsraums.
Der schönste Befund unterwegs: Verschränkung ist mathematisch nichts Exotisches, sondern das Scheitern der Tensorfaktorisierung — ein Zustand ist genau dann verschränkt, wenn er sich nicht mehr in zwei getrennte Vektoren zerlegen lässt. Und die Boolesche Algebra? Sie verschwindet nicht, aber sie rückt an den Rand: Sie regiert nur noch, was hineingeht und was herauskommt — die Messung und das reversible Einbetten klassischer Logik. Sie ist die Schnittstelle, nicht der Motor.
Am Ende schließt sich der Kreis zu Backus. Ein Quantenschaltkreis kennt keinen Speicher, keine Zuweisung, keine schrittweise Zustandsänderung. Er ist Komposition von Funktionen mit einer echten Algebra dahinter — genau der funktionale Stil, den Backus 1977 forderte. Niemand hat das so geplant; die Physik ließ keine andere Wahl.
→ Zum Artikel: The Math behind Quantum Computing

Was ist ein Tensor? Vom Kronecker-Produkt zu den Tensor Netzwerken
Wer im Internet nach einer Einführung sucht, gerät schnell in die Irre: Der Begriff meint in der Physik etwas anderes als im Quantencomputing — und deutschsprachiges Material, das den Bogen bis zu den Tensor Netzwerken schlägt, ist kaum zu finden.
Dieser Artikel versucht genau das.
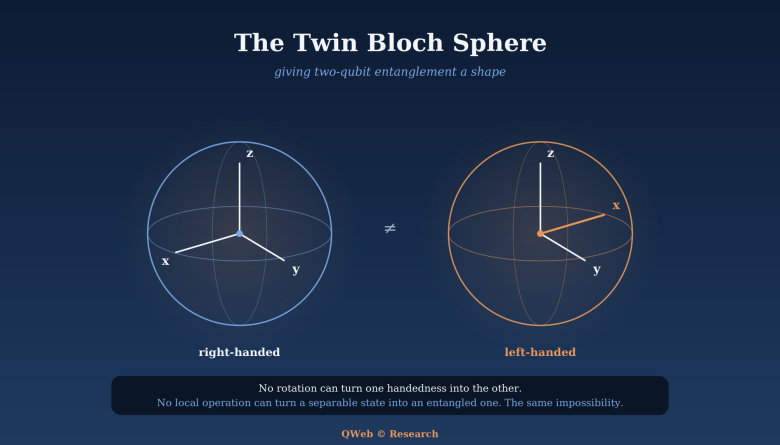 Die Zwillings-Bloch-Kugel: eine Geometrie für Verschränkung
(im Original: „The Twin Bloch Sphere: A Geometry for Entanglement")
Ein Qubit hat ein schönes Bild: einen Punkt auf einer Kugel. Zwei Qubits hatten bislang keines — und das nicht aus Mangel an Versuchen. Das Hindernis ist präzise benennbar: Spurt man ein Qubit eines maximal verschränkten Zustands aus, ist die reduzierte Dichtematrix proportional zur Einheitsmatrix. Der Bloch-Vektor hat die Länge null. Alle vier Bell-Zustände fallen damit auf dasselbe Bild zusammen — zwei Kugeln, zwei Punkte im Zentrum —, obwohl sie zueinander orthogonal sind und sich physikalisch deutlich unterscheiden.
Eine Arbeit von Stanislav Filatov und Mārcis Auziņš von der Universität Lettland aus dem Jahr 2024 findet die fehlende Struktur an einer unerwarteten Stelle: nicht in den Pfeilen, sondern in den Koordinatenachsen selbst.
Der Artikel folgt der Mathematik Schritt für Schritt. Er beginnt beim Tensorprodukt — wie ℂ² ⊗ ℂ² = ℂ⁴ die Größe des Problems festlegt (sechs reelle Parameter für einen reinen Zwei-Qubit-Zustand), und warum die Lie-Algebra-Isomorphismen spin(6) ≈ so(6) ≈ su(4) einen sechsdimensionalen reellen Raum verlangen. Zwei Bloch-Kugeln liefern genau sechs Koordinatenachsen.
Dann eine bemerkenswerte Übereinstimmung zweier voneinander unabhängiger Abzählungen: Die Zwei-Qubit-Pauli-Basis umfasst 4 × 4 = 16 Operatoren, abzüglich I⊗I bleiben 15. Und sechs Achsen spannen C(6,2) = 15 Rotationsebenen auf. Sechs dieser Ebenen liegen innerhalb einer Kugel — das sind die lokalen Rotationen, die niemals Verschränkung erzeugen können. Die übrigen neun verbinden eine Achse der einen mit einer Achse der anderen Kugel. Nur dort kann Verschränkung entstehen.
Ein eigener Abschnitt erklärt, warum die Autoren zur Geometrischen Algebra greifen: In drei Dimensionen beschreibt man eine Rotation bequem durch ihre Achse, weil jede Ebene genau eine Normale besitzt. In sechs Dimensionen versagt das — der Begriff „Rotationsachse" wird sinnlos, während der Begriff „Rotationsebene" wohldefiniert bleibt. Genau dafür liefert die Geometrische Algebra mit dem Bivektor das Vokabular.
Den Kern bildet schließlich die Händigkeit: Ein maximal verschränkter Zustand wird durch zwei Bloch-Kugeln dargestellt, deren Koordinatenachsen entgegengesetzte Händigkeit haben — die eine rechtshändig, die andere linkshändig. Warum das funktionieren kann, hat einen tiefen Grund: Keine Rotation kann Händigkeit verändern, das unterscheidet sie von einer Spiegelung. Und keine lokale Operation kann einen separablen Zustand in einen verschränkten überführen. Diese beiden Unmöglichkeiten sind dieselbe Unmöglichkeit — deshalb trägt die Geometrie.
Bemerkenswert und im Artikel ausdrücklich erwähnt: Die Autoren fanden diese Struktur nicht über die Geometrie, sondern indem sie die vier Bell-Zustände in allen drei konjugierten Basen neu aufschrieben und schauten, was gleich blieb.
Der Artikel benennt auch die Grenzen — nur reine Zustände, nur zwei Qubits, mehrere konkurrierende Ansätze — und schließt mit dem Bogen zur Ausgangsfrage meiner Artikelreihe: Wann besitzt ein Teilsystem einen eigenen Zustand? Die algebraische Antwort lautet: wenn sich der Zustand als A ⊗ B schreiben lässt. Die geometrische Antwort lautet: wenn die beiden Koordinatensysteme dieselbe Händigkeit haben. Dieselbe Tatsache in zwei Sprachen.
→ Zum Artikel: The Twin Bloch Sphere: A Geometry for Entanglement
Distributed Quantum Computing (DQC)
 Wer hat zuerst gemessen? Verschränkung und die Relativität des Kollapses
(im Original: „Whose Measurement Came First? Entanglement and the Relativity of Collapse")
Wann besitzt ein Teilchen einen eigenen Zustand — und wann existiert es nur als Teil eines größeren Ganzen? Dieser Artikel nähert sich der Frage über ein Gedankenexperiment: Zwei maximal verschränkte Qubits werden weit voneinander getrennt und quasi gleichzeitig gemessen. Wer von beiden Beobachtern hat die „erste" Messung durchgeführt und damit den Zustand des Paares festgelegt?
Die Antwort ist verblüffend: Es gibt keine. Weil die beiden Messereignisse raumartig getrennt sind, ordnen verschiedene Beobachter ihre zeitliche Reihenfolge unterschiedlich — und keine Sichtweise
ist bevorzugt. Der Artikel zeigt, warum das kein Widerspruch ist: Alle beobachtbaren Größen, insbesondere die Korrelationen der Messergebnisse, sind von der angenommenen Reihenfolge vollständig
unabhängig. Der „Kollaps" der Wellenfunktion erweist sich damit weniger als reales physikalisches Ereignis, sondern als Merkmal unserer Beschreibung.
Auf dem Weg dorthin führt der Beitrag durch die Bell-Ungleichung und den CHSH-Test (benannt nach Clauser, Horne, Shimony und Holt), erklärt die Tsirelson-Grenze und die experimentellen Schlupflöcher
samt ihrer Schließung in den lückenlosen Tests von 2015.
Abschließend wird der Bogen zu praktischen Anwendungen geschlagen — zertifizierte Zufallszahlen und geräteunabhängige Schlüsselverteilung — und zurück zur Ausgangsfrage nach lokaler und globaler Information in verteilten Quantennetzwerken:
Was verschränkte Qubits leisten — und was nicht
Verschränkte Qubits tragen eine Korrelation, die nachweislich stärker ist als alles klassisch Erklärbare: Der Bell-Test schließt aus, dass die Messergebnisse auf einer vorab vereinbarten Absprache beruhen. Darin liegt ihr kryptografischer Wert — das Paar trägt ein gemeinsames Geheimnis, das Außenstehende nicht auslesen können, weil es vor der Messung schlicht noch nicht existierte.
Zugleich verführt dieser Befund zu einem Fehlschluss. Verschränkung überträgt keine Information: Keine Handlung an einem Qubit erzeugt am anderen eine beobachtbare Änderung, und jedes darauf aufbauende Protokoll — Schlüsselverteilung, Teleportation, Entanglement Swapping — benötigt zusätzlich einen klassischen, durch die Lichtgeschwindigkeit begrenzten Kanal.
Was geteilte Verschränkung verändert, ist daher nicht die Latenzgrenze, sondern die Menge der nötigen klassischen Kommunikation: Für bestimmte verteilte Aufgaben müssen Parteien mit verschränkten Paaren nachweislich weniger klassische Bits austauschen als Parteien ohne. Die Lichtgeschwindigkeit bleibt die Untergrenze dafür, wie schnell sich Übereinstimmung in einem Netzwerk ausbreiten kann — Verschränkung senkt lediglich den Preis, sie zu erreichen.
→ Zum Artikel: Whose Measurement Came First? Entanglement and the Relativity of Collapse
 Wie Verschränkung den Preis der Übereinstimmung senkt
(im Original: „How Entanglement Lowers the Price of Agreement")
Jedes verteilte System zahlt dieselbe Rechnung: Seine Knoten halten lokale Information, seine Aufgaben verlangen global konsistente Antworten — und die Lücke dazwischen muss mit Kommunikation bezahlt werden, die nie schneller als das Licht reist. Dieser Artikel fragt, was Verschränkung an dieser Rechnung ändert, und was nicht.
Die Antwort beginnt mit den harten Grenzen: Verschränkung überträgt selbst keinerlei Information (No-Signalling), und für den reinen Datentransport hilft sie höchstens um den Faktor zwei (Holevo-Schranke, Superdense Coding). Die eigentliche Bühne ist die Kommunikationskomplexität (Yao 1979) — die Frage, wie viele Bits zwei Parteien mindestens austauschen müssen, um eine gemeinsame Funktion ihrer verteilten Eingaben zu berechnen. Hier zeigt der Artikel den Bogen von der ersten Ein-Bit-Einsparung (Cleve–Buhrman 1997) über quadratische bis hin zu bewiesenen exponentiellen Vorteilen (Raz 1999, Hidden Matching).
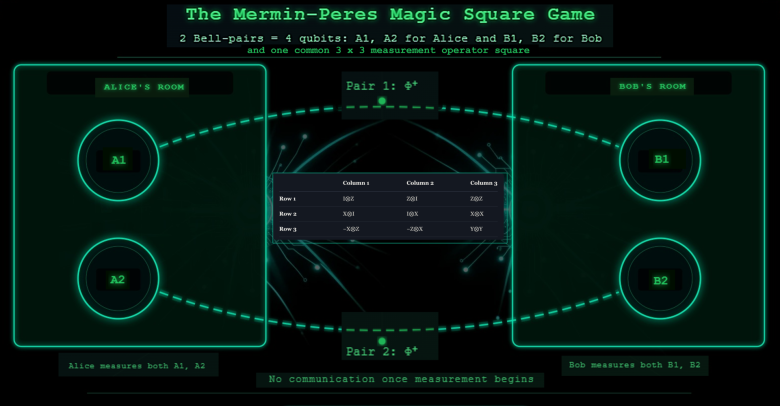
Den Höhepunkt bildet das Mermin–Peres-„Magic-Square"-Spiel (Das Mermin-Peres Magic Square auf Wikipedia: https://en.wikipedia.org/wiki/Quantum_pseudo-telepathy und auf YouTube: https://www.youtube.com/watch?v=ahsaT6y7Zig): eine Aufgabe, die zwei Parteien mit geteilten Bell-Paaren in jeder Runde sicher gewinnen — ganz ohne Kommunikation —, während jede klassische Strategie beweisbar an mindestens einer von neun Kombinationen scheitert. Zugleich benennt der Artikel die Grenzen: Für manche Funktionen (etwa das innere Produkt) verschwindet der Vorteil vollständig, und die Latenzgrenze c bleibt in jedem Fall unangetastet.
Der Schluss spannt den Bogen zu meiner Diplomarbeit von 1986 („Sprachkonzepte zur Darstellung lokaler und globaler Information für die Ablaufsteuerung von parallelen Prozessen"): Deren These — vollständige Konsistenz lokaler und globaler Information ist wegen c unerreichbar — wird durch die Quantenmechanik nicht widerlegt, sondern verfeinert. Verschränkung senkt die Kosten der Konsistenz, für manche Aufgaben exponentiell, für einige auf null — die Lichtgeschwindigkeit als Untergrenze bleibt.
→ Zum Artikel: How Entanglement Lowers the Price of Agreement
 Das Mermin–Peres Magic Square Game und die Implementierung in Qiskit
(im Original: „The Mermin–Peres Magic Square Game")
Können zwei Parteien, die nicht miteinander kommunizieren dürfen, sich trotzdem so abstimmen, als hätten sie sich auf einen unmöglichen Antwortschlüssel geeinigt? Klassisch lautet die Antwort nein — ein einfaches Paritätsargument zeigt, dass jede vorab festgelegte 3×3-Tabelle bei mindestens einer von neun möglichen Abfragen scheitern muss. Dieser Artikel baut das Mermin-Peres Magic Square Game Schritt für Schritt auf: von der klassischen Unmöglichkeit über zwei geteilte verschränkte Qubit-Paare und die neun quantenmechanischen Messoperatoren, die das Spiel realisieren, bis zur operatoralgebraischen „Magie" — zwei bewusst mit Vorzeichen versehene Zellen —, die es zwei Spielern erlaubt, jede einzelne Runde mit Sicherheit zu gewinnen. Den Abschluss bildet der Bezug zum Kochen-Specker-Theorem über Quantenkontextualität.
→ Zum Artikel: The Mermin–Peres Magic Square Game
→ Zur Implementierung: The Mermin–Peres Magic Square Game in Qiskit
 Die Analogie, die fast funktioniert: Warum klassische Bilder der Verschränkung zerbrechen
(im Original: „The Analogy That Almost Works: Why Classical Pictures of Entanglement Break")
Zwei gemeinsam angestoßene Kreisel behalten ihre Achsenausrichtung, wie weit sie sich auch voneinander entfernen. Zwei synchron angestoßene Pendel schwingen dauerhaft in derselben Ebene. Öffnet man in Wien eine von zwei Handschuhschachteln, weiß man augenblicklich, was in Tokio liegt. Solche Bilder lassen Verschränkung gewöhnlich erscheinen — und sie sind alles andere als naiv. Es ist genau die Position, die Einstein 1935 im EPR-Aufsatz vertrat.
Ihre Hartnäckigkeit rührt daher, dass sie über weite Strecken nicht bloß ungefähr, sondern exakt zutreffen. Messen beide Seiten entlang derselben Achse, gibt das klassische Bild die Quantenmechanik perfekt wieder. Bei senkrechten Achsen ebenso. Und beide Bilder verbieten gleichermaßen, ein Signal zu übertragen — jede Seite sieht für sich nur Zufall.
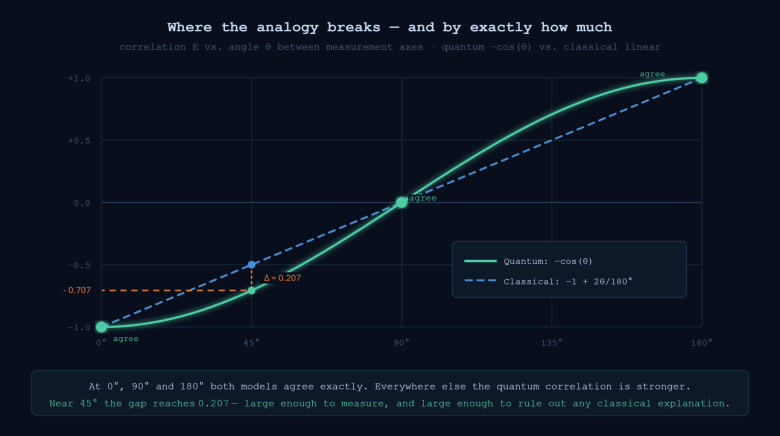
Bells Einfall bestand darin, nach den Winkeln zu fragen, die niemand geprüft hatte. Bei 45° sagt ein Modell mit vorab verabredeten Werten eine Korrelation von −0,50 voraus, die Quantenmechanik dagegen −0,707. Bemerkenswert ist dabei die Richtung der Abweichung: Die tatsächliche Korrelation ist die stärkere. Keine noch so raffinierte Vorabverabredung kann so eng koordinieren, wie die Natur es tut.
Der Artikel verfolgt diese Lücke von der Kurve über die CHSH-Zahl bis zur Messung im Labor — klassisch höchstens 2, quantenmechanisch 2√2 ≈ 2,83, seit 1972 gemessen und 2015 lückenlos bestätigt. Er erklärt, warum sich das Pendel nicht reparieren lässt: nicht weil es zu einfach wäre, sondern weil es zu bestimmt ist. Ein Pendel besitzt eine Schwingungsebene, auch wenn niemand hinsieht; ein Spin besitzt keinen festen Wert entlang aller Achsen zugleich. Hier schließt sich der Bogen zum Mermin-Peres-Quadrat, das genau dies vorführt.
Zwei weitere Abschnitte grenzen ab: Robert Spekkens' Spielzeugtheorie von 2007 als raffiniertester klassischer Versuch — sie reproduziert erstaunlich viel, kann aber die Bell-Ungleichung nicht verletzen. Und die sogenannte „klassische Verschränkung" in der Optik, mathematisch dieselbe Nicht-Faktorisierbarkeit, physikalisch aber ohne jede Nichtlokalität.
Das Fazit ist kein Abgesang auf die Analogien. Sie sind die beste klassische Näherung, die es gibt — und zu wissen, wo genau sie scheitern, ist lehrreicher, als sie nie versucht zu haben.
→ Zum Artikel: The Analogy That Almost Works
Quantum Networks (QNT)
 Tensor-Netzwerke im großen Maßstab: Wo HPC und verteiltes Quantencomputing zusammentreffen
(im Original: „Tensor Networks at Scale: How HPC and Distributed Quantum Computing Meet")
Ein Quantenzustand aus 300 Teilchen braucht zu seiner Beschreibung mehr Zahlen, als das beobachtbare Universum Atome hat. Tensor-Netzwerke drücken das auf wenige Millionen — aber auch wenige Millionen Tensoren müssen irgendwo gespeichert, kontrahiert und aufsummiert werden. Dieses „irgendwo" ist eine massiv parallele Maschine. Und genau dort treffen die klassische und die quantenmechanische Seite des Problems tatsächlich aufeinander.
Der Artikel setzt dort an, wo meine deutschsprachige Einführung „Was ist ein Tensor?" aufhört, und verfolgt die Ingenieursseite.
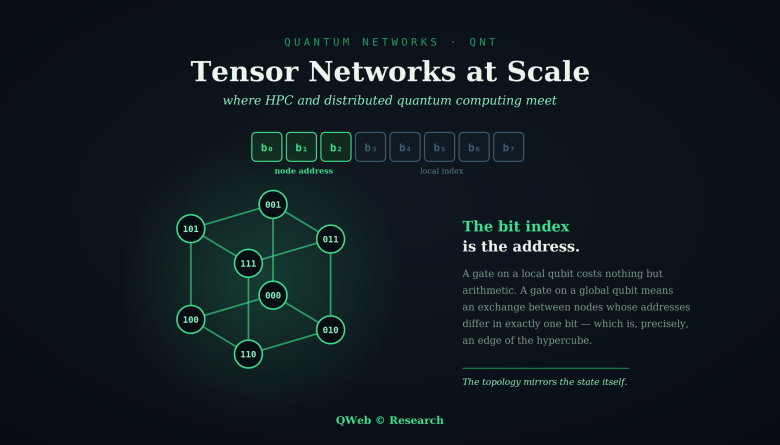
Warum ausgerechnet der Hyperwürfel? Eine Amplitude eines n-Qubit-Zustands trägt eine Adresse aus n Bits. Nimmt man k davon als Knotenadresse, so gilt: Ein Gatter auf einem lokalen Qubit ist reine Lokalrechnung ohne jeden Datenverkehr. Ein Gatter auf einem globalen Qubit dagegen erfordert einen Austausch zwischen Knoten, deren Adressen sich in genau einem Bit unterscheiden — und das ist per Definition eine Kante des Hyperwürfels. Die Topologie ist also kein Implementierungsdetail, sondern spiegelt die Struktur des Zustands selbst. Wer in den 1980er Jahren an paralleler Ablaufsteuerung gearbeitet hat, erkennt die Frage wieder: Wo platziert man Information im Prozessornetz, damit die teuren Transfers minimal bleiben?
Kontraktion ist die eigentliche Arbeit. Der Artikel erklärt das Verfahren des Slicing, mit dem eine einzige riesige Kontraktion in viele unabhängige zerlegt wird, und zwei Befunde, die aus der gewöhnlichen HPC-Welt überraschen: Eine bessere Kontraktionsreihenfolge bringt mehr als eine größere Maschine — mehr als eine Größenordnung. Und in der Cloud scheitert das Verfahren nicht an fehlender Rechenleistung, sondern an der Latenz.
Die Brücke zum verteilten Quantencomputing: Dieselbe Mathematik wird zur Koordinationsschicht zwischen getrennten Quantenprozessoren. Ein zu großer Schaltkreis wird zerschnitten, die Teile laufen auf kleineren QPUs, und die Rekonstruktion des Gesamtergebnisses geschieht als Tensor-Kontraktion. Der klassische Höchstleistungsrechner konkurriert hier nicht mit den Quantenrechnern — er ist das, was mehrere von ihnen wie einen erscheinen lässt.
Die Anwendung, die sich schon heute rechnet: Risikoquantifizierung in Banken und Versicherungen. Monte-Carlo-Simulation konvergiert nur mit 1/√N — eine zusätzliche Dezimalstelle kostet das Hundertfache an Rechenzeit. Tensor-Netzwerke stellen die Verteilung dar, statt sie abzutasten; für die Bewertung von Multi-Asset-Optionen wurden mehrere Größenordnungen Vorsprung berichtet. Crédit Agricole CIB, BBVA und die Bank of Canada haben dazu reale Experimente durchgeführt.
Der entscheidende Punkt wird dabei leicht übersehen: Es handelt sich um quanteninspirierte klassische Algorithmen. Sie laufen heute, auf Hardware, die eine Bank ohnehin besitzt. Kein Kryostat, keine Qubit-Zahl, kein Warten auf Fehlertoleranz.
Und ein Vorteil, der in der Berichterstattung fast nie vorkommt: Ein Matrixproduktzustand liefert interpretierbare Wahrscheinlich-keiten statt undurchsichtiger Gewichte. Für jeden, der schon einmal eine Modellvalidierung miterlebt hat, ist diese Eigenschaft von Bedeutung. Stünden Finanzinstitute vor der Wahl zwischen einem Modell, welches zehnmal schneller läuft, und einem, welches eine Prüfungsinstanz tatsächlich nachvollziehen kann, würden sich viele für Letzteres entscheiden.
→ Zum Artikel: Tensor Networks at Scale
 Was ein Knoten tatsächlich enthält
(im Original: „What a Node Actually Holds")
Verteilt man einen Quantenzustand über einen Rechnerverbund, gibt es zwei Arten, ihn zu zerschneiden. Sie sind keine Spielarten derselben Idee — und der Unterschied entscheidet darüber, was das Ganze kostet.
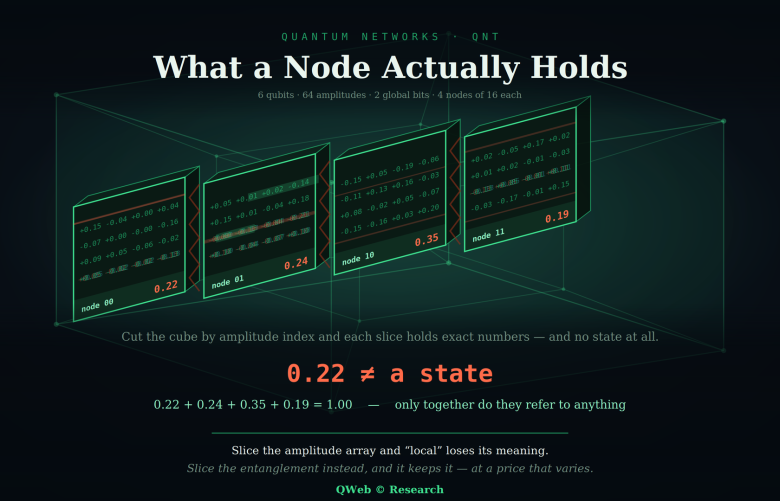
Die erste zerlegt das Amplitudenfeld. Der Qubit-Index wird zur Knotenadresse; ein Gatter auf einem globalen Qubit bedeutet einen Austausch über eine Kante des Hyperwürfels. Das Verfahren funktioniert, und die Rechnung geht auf.
Es hat allerdings eine Folge, die mir erst beim Nachrechnen klar wurde: Ein Knoten hält in diesem Schema überhaupt keinen Zustand. Nicht etwa einen leeren — gar keinen. Um den reduzierten Zustand seiner Qubits zu bilden, müsste über alle anderen Knoten summiert werden.
Im Artikel steht dazu ein Beispiel mit vier Qubits, klein genug, um es vollständig abzudrucken: sechzehn Amplituden als Tabelle, jede Zeile ein Knoten. Die vier quadrierten Zeilennormen ergeben zusammen 1, jedoch keine einzelne für sich. Was ein Knoten allein bilden kann, hat die Spur 0,1969 — also genau seinen eigenen Anteil. Exakte Zahlen, aber ohne physikalischen Bezug.
Die zweite zerlegt die Verschränkung. In einem Tensor-Netzwerk gehört jeder Tensor zu einem Ort, die Bindungen tragen die Korrelation, und „lokal" bedeutet dort, was es sonst auch bedeutet.
Und dann laufen die Kosten auseinander. Der Hyperwürfel bewegt stets dieselben 512 Amplituden — ob der Zustand ein reiner Produktzustand oder vollständig durchmischt ist, spielt keine Rolle. Er ist blind gegenüber Verschränkung, was nicht überrascht, da er sie nie dargestellt hat. Das Tensor-Netzwerk reicht von zwanzig bis zwanzigtausend Zahlen und folgt der Entropie genau. Die beiden Verfahren kreuzen sich bei etwa 1,4 Bit.
Damit ist der Handel ehrlich beschrieben: eine feste Gebühr, die man immer zahlt, gegen eine schwankende, die weit darunter oder weit darüber liegen kann.
Ein Vorzug des Hyperwürfels wird dabei leicht übersehen: Weil er blind gegenüber Verschränkung ist, kann er auch nicht schlecht zu ihr passen. Eine angepasste Struktur ist besser, wenn sie passt, und schlechter, wenn nicht — und man erfährt es erst hinterher. Sie verlangt genau jenes Wissen, das man noch nicht hat.
Der Beitrag schließt mit einer Rückbindung an die Leitfrage dieser Seite. Neben „lokal bestimmt" und „lokal leer" gibt es hier einen dritten Fall: lokal bedeutungslos. Und daraus folgt eine Unterscheidung, die mir wesentlich scheint — ist ein Teil ein Teil des Systems oder nur ein Teil der Beschreibung?
→ Zum Artikel: What a Node Actually Holds
Quantum Security & Cryptography (SEC)
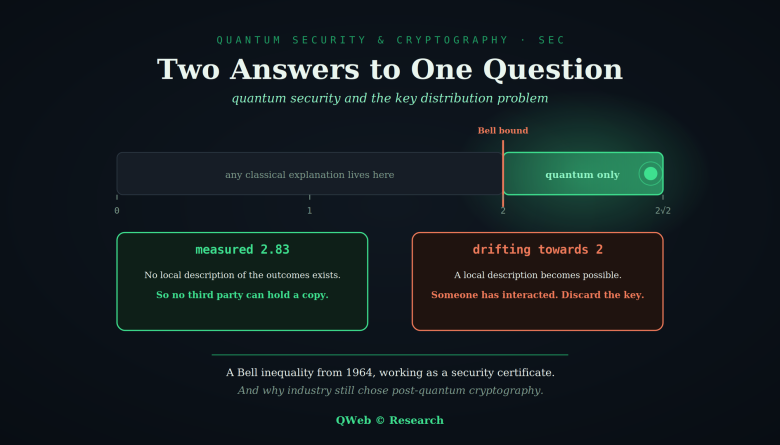 Zwei Antworten auf eine Frage: Quantensicherheit und das Schlüsselverteilungsproblem
(im Original: „Two Answers to One Question: Quantum Security and the Key Distribution Problem")
Hinter dem Begriff „Quantensicherheit" verbergen sich zwei Fragen, und sie haben unterschiedliche Antworten. Die erste lautet wie funktioniert das — und die Antwort ist bemerkenswert. Die zweite lautet was soll mein Haus tun — und diese Antwort ist nüchterner, hat eine Frist, und kommt weitgehend ohne Quantenhardware aus. Der Artikel gibt beide und hält sie sauber auseinander.
Teil I folgt der Physik. Das No-Cloning-Theorem, hier in drei Zeilen bewiesen, ist der Grund, warum ein Lauscher nicht einfach eine Kopie nehmen und das Original unverändert weiterreichen kann. Von dort zu den beiden Wegen der Quantenschlüsselverteilung: BB84 von 1984 kommt ganz ohne Verschränkung aus, E91 von 1991 nutzt sie. Verschränkung ist für QKD also hinreichend, aber nicht notwendig — was die Frage aufwirft, wozu der aufwendigere Weg dann gut ist.
Die Antwort darauf bildet das Herzstück des Artikels: Eine gemessene Bell-Verletzung ist ein Sicherheitszertifikat. Besäße die Lauscherin Eve irgendeine Aufzeichnung über den Schlüssel, dann existierte eine lokale Beschreibung der Messergebnisse — nämlich jene, die ihre Aufzeichnungen einschließt. Und existierte eine solche Beschreibung, könnte der CHSH-Wert nicht über 2 liegen. Ein gemessener Wert nahe 2√2 bezeugt also, dass sie nichts hat. Das nennt man geräteunabhängige Schlüsselverteilung: Man muss dem Hersteller der Geräte nicht vertrauen, sondern nur der Zahl, die sie ausgeben. Eine Kuriosität aus dem Jahr 1964 ist damit zum Betriebsmittel geworden.
Teil II fragt, was daraus folgt — und antwortet anders. „Harvest now, decrypt later" macht die Frist konkret: Heute mitgeschnittene Daten lassen sich später entschlüsseln. Die Rechnung ist einfach: Vertraulichkeitsdauer plus Migrationsdauer, verglichen mit der Ankunft leistungsfähiger Hardware.
Die Industrie hat sich dennoch für Post-Quanten-Kryptografie entschieden und gegen QKD — aus handfesten Gründen. Photonen lassen sich nicht kopieren und deshalb auch nicht verstärken; ausgerechnet das Theorem, das die Sicherheit liefert, verbietet den Repeater, der die Reichweite verlängern würde. Lange Strecken brauchen daher vertrauenswürdige Zwischenknoten — und führen genau die Vertrauensannahme wieder ein, die QKD beseitigen sollte.
Der Artikel nennt die Standards (NIST, 13. August 2024: ML-KEM, ML-DSA, SLH-DSA), die Fristen (US-Verfügung vom Juni 2026: 2030 und 2031) und die konkreten Schritte: Inventur, Priorisierung nach Vertraulichkeitsdauer, hybride Verfahren, Krypto-Agilität.
Und er nennt das ehrliche Gegenargument: PQC könnte fallen. Ihre Sicherheit ruht auf jungen mathematischen Annahmen. SIKE, ein NIST-Kandidat der vierten Runde, wurde 2022 in Polynomialzeit gebrochen — auf einem gewöhnlichen Rechner, in etwa einer Stunde. Physikalische Gesetze dagegen werden nicht kryptanalysiert.
→ Zum Artikel: Two Answers to One Question
Quantum Artificial Intelligence (QAI)
 Die Verschmelzung von KI und Quantencomputing: Quanten-KI (QAI)
(The Merge of AI with QC: Quantum AI (QAI))
„KI plus Quantencomputing" mag nach einem einzigen riesigen Supercomputer klingen – doch die Architektur, die sich heute tatsächlich herausbildet, ist subtiler und weitaus interessanter. In aktuellen Forschungssystemen übernehmen die drei Technologien unterschiedliche, sich ergänzende Rollen: KI unterstützt Forscher beim Entwerfen von Experimenten, beim Interpretieren von Ergebnissen, beim Optimieren von Quanten-schaltkreisen und beim Orchestrieren zunehmend komplexer Arbeitsabläufe. Quanten-prozessoren bearbeiten ausgewählte Probleme mit einem grundlegend anderen Rechenmodell. Und klassische Supercomputer leisten weiterhin den Großteil der eigent-lichen Rechenarbeit drumherum.
Das Ergebnis ist ein hybrider Stack: KI für Vorhersage und Automatisierung, GPUs für Simulation und Hochleistungsrechnen, Quantenprozessoren für spezialisierte Experimente. Alle großen Technologieunternehmen investieren in die Software, die diese Ebenen miteinander verbindet – Google mit Cirq und TensorFlow Quantum, Microsoft mit Azure Quantum, Q# und seinem Quantum Development Kit, IBM mit dem Qiskit-Ökosystem für Quantenalgorithmen und Machine-Learning-Forschung sowie NVIDIA mit cuQuantum für beschleunigte Quantensimulation und CUDA-Q für hybride Workflows.
Nichts davon bedeutet, dass Quantencomputer KI-Systeme oder herkömmliche Rechen-zentren in absehbarer Zeit ersetzen werden. Die eigentliche Chance liegt heute im Zu-sammenspiel aller drei Ebenen – KI, klassisches Hochleistungsrechnen und Quanten-hardware. Langfristig könnte diese kombinierte Architektur die Chemiesimulation, die Ma-terialforschung, die Optimierung und die wissenschaftliche Entdeckung voranbringen. Und es könnte sich durchaus herausstellen, dass die Unternehmen, die die verbindende Software bauen, genauso wichtig sind wie jene, die die Quantenprozessoren selbst entwickeln.
→ Zum Artikel: https://qweb-quantum.com/pub-quantum-ai-qai
 Laufen LLMs auf Quantencomputern? Noch nicht – aber es tut sich etwas anderes
Laufen LLMs auf Quantencomputern?
Noch nicht – aber es tut sich etwas anderes
(im Original: „Quantum Computing and Large Language Models: Where We Actually Stand")
Es ist eine weit verbreitete Annahme: Bei all den Schlagzeilen zum Thema Quantencomputing in letzter Zeit müssen Claude oder ChatGPT doch mittlerweile sicherlich auf Quantenhardware laufen, oder? Das tun sie nicht – und die heutigen Quantenprozessoren sind für diese Art von Arbeitslast nicht ausgelegt. Aber zwei weniger beachtete Entwicklungen sind erwähnenswert. Forschern ist es kürzlich gelungen, mit einem echten 156-Qubit-Quantenprozessor von IBM die Genauigkeit eines Llama-Modells messbar zu verbessern – und zwar mithilfe eines winzigen Quanten-Add-ons anstelle des Modells selbst. Unterdessen revanchiert sich die KI: Neue Open-Source-Modelle von Nvidia beschleunigen die Kalibrierung und Fehlerkorrektur von Quantenhardware, und Sprachmodelle wie Claude halfen einem Team dabei, die pro Qubit benötigte Atomanzahl um den Faktor 100 zu reduzieren. Keines davon ist ein Quanten-LLM. Beide sind Schritte in Richtung etwas Interessanterem.
→ Zum Artikel: https://qweb-quantum.com/blog/quantum-ai-llm
Quantum Machine Learning (QML)
 Quantum Machine Learning: Was davon tatsächlich stimmt
(im Original: „Quantum Machine Learning: What Is Actually True")
Vorausschauende Datenanalyse gehört zu den am weitesten verbreiteten Anwendungen der Informationstechnik — und stößt an eine harte Grenze, den sogenannten Fluch der Dimensionalität: Jedes zusätzliche Merkmal fügt dem Suchraum eine Dimension hinzu, und dieser Raum wächst exponentiell. Irgendwann deckt die verfügbare Datenmenge den Raum, in dem sie lebt, nicht mehr ab.
Quantum Machine Learning verspricht eine Antwort darauf: Ein System aus n Qubits spannt einen Zustandsraum von 2ⁿ Dimensionen auf — warum also nicht darin lernen? Der Zustandsraum ist real. Ob er sich nutzen lässt, ist eine andere Frage.
Der Artikel folgt den Belegen. Er beschreibt die zwei Nadelöhre, die einen echten Vorteil bislang so schwer nachweisbar machen: Klassische Daten müssen erst in einen Quantenzustand geladen werden — und dieser Schritt kann mehr kosten, als die erhoffte Beschleunigung einbringt. Und am anderen Ende liefert eine Messung nur gewöhnliche Bits, niemals den ganzen Zustandsraum.
Ein eigener Abschnitt gilt der Dequantisierung: Seit Ewin Tangs Ergebnis von 2018 wurden mehrere behauptete Quantenvorteile durch verbesserte klassische Algorithmen wieder eingeholt. Das liest sich zunächst wie eine Reihe von Niederlagen — tatsächlich ist es ein Schärfungswerkzeug, das zeigt, wo ein Vorteil nicht liegt und wo er plausibel bleibt: in Daten mit echter Quanten- oder algebraischer Struktur, nicht in Tabellenkalkulationen.
Dann der Praxistest: Über fünfzehn große Banken betreiben Quantenforschungsprogramme. Keine einzige setzt ein Quantensystem produktiv ein. Goldman Sachs hat beziffert, was für einen realistischen Anwendungsfall nötig wäre — rund 7.500 logische Qubits. Was heute dagegen tatsächlich Wert liefert, sind quanteninspirierte klassische Algorithmen.
Zwei Fragen behandelt der Artikel, die selten zusammen gestellt werden. Erstens die Energiefrage: Wäre maschinelles Lernen auf Quantenhardware energieeffizienter als in den heutigen Rechenzentren? Die Antwort ist komplizierter als die Schlagzeile. Der Prozessor selbst verbraucht praktisch nichts — aber ihn auf wenige Tausendstel Grad über dem absoluten Nullpunkt zu halten, kostet 15 bis 25 Kilowatt. Ein klassisches Rechenzentrum verwendet rund 80 Prozent seiner Energie fürs Rechnen und kann sich durch bessere Kühlung verbessern. Ein Quantensystem verwendet über 99,99 Prozent für Kühlung und Steuerelektronik — die Kühlung ist dort kein Overhead, sondern die Voraussetzung, und sie lässt sich nicht herunterskalieren.
Zweitens die Architekturfrage: Wenn ein Quantenprozessor nur sekundenweise innerhalb eines langen klassischen Vorgangs aufgerufen wird, trägt er seine Kühllast durchgehend, liefert aber nur kurz Rechenleistung. Damit wird die Auslastung zur entscheidenden Größe — und ein geteilter, verteilter Beschleuniger hat ein völlig anderes Energieprofil als einer, der im Keller einer einzelnen Organisation leerläuft. Genau dort schließt sich der Kreis zur QWeb-Architektur.
Fazit: Nicht, dass an Quantum Machine Learning nichts dran wäre – nur liegt das Spannende woanders, als die Werbebotschaften glauben machen wollen.
→ Zum Artikel: Quantum Machine Learning: What Is Actually True
QWeb © Architecture (QWB)
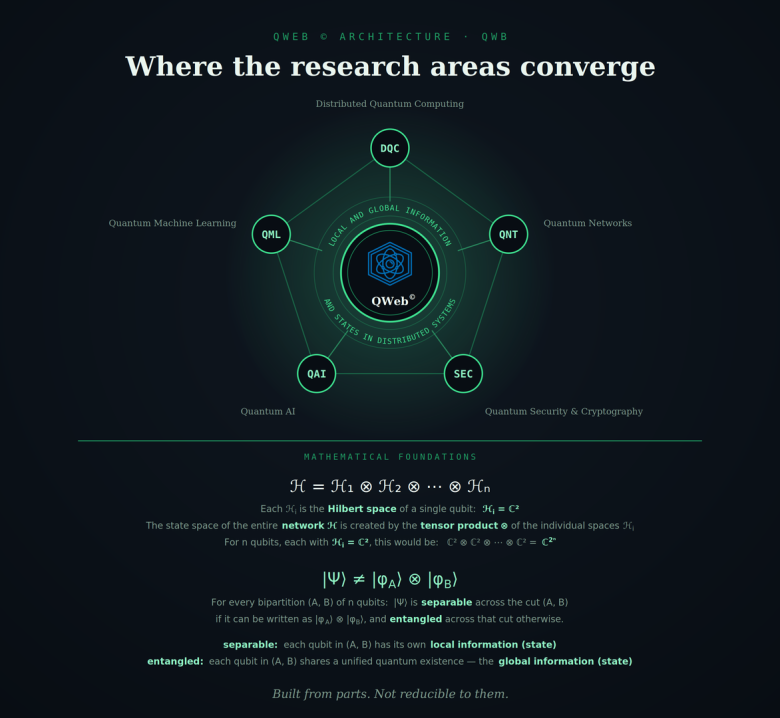 Wo die vorangehenden Forschungsbereiche zur QWeb © Architektur zusammenlaufen
(im Original: „Where the Research Areas Converge")
Auf QWeb © Research (www.qweb-quantum.com) sind Beiträge zu fünf Forschungsbereichen entstanden — zur Geometrie der Verschränkung, zu Tensor-Netzwerken auf Höchstleistungsrechnern, zur Frage, was Quantensicherheit leistet und was nicht. Jeder Bereich mit seiner eigenen Fragestellung.
Der neue Abschnitt ist der Ort, an dem sie zusammenlaufen. Und er beginnt dort, wo jede Architektur beginnen muss: bei der Mathematik, die sagt, was ein verteiltes Quantensystem eigentlich ist.
Zwei Formeln tragen die gesamte Argumentation.
Die erste beschreibt den Aufbau: Der Zustandsraum des Netzes entsteht als Tensorprodukt der Räume seiner Knoten. Jeder Knoten bringt seinen eigenen Hilbertraum ein — bei einem Qubit schlicht ℂ2 —, und das Ganze wächst dabei nicht additiv, sondern multiplikativ auf die Dimension 2n.
Die zweite beschreibt die Grenze dieses Aufbaus: Zerlegt man das Netz in zwei Gruppen A und B, so lässt sich fragen, ob der Gesamtzustand als Produkt zweier Gruppenzustände darstellbar ist. Gelingt das, sind die Gruppen unabhängig voneinander beschreibbar — lokale Information und Zustände. Gelingt es nicht, dann ist der Zustand über diesen Schnitt hinweg verschränkt: Kein Teil besitzt dann noch einen eigenen, für sich beschreibbaren Zustand, und die Gruppen teilen sich eine gemeinsame Existenz — globale Information und Zustände.
Aus Teilen aufgebaut. Nicht auf sie zurückführbar.
Auf diesen beiden Zeilen ruht alles Weitere: warum Verteilung die natürliche Bauform für Quantencomputing ist, warum die Verbindungsstruktur wichtiger wiegt als der einzelne Prozessor, und warum Verschränkung eine Ressource ist, die man verteilen und lenken muss — und nicht bloß ein Phänomen, das man bestaunt.
Inzwischen ist der Abschnitt gewachsen. Fünf Stränge führen die These aus — die Verschränkungsentropie als abrechenbare Größe, ein Verfahren aus der Graphentheorie zur Frage, wo ein Quantennetz geteilt werden sollte, und der Lernmechanismus, der diese Entscheidung nachführt, während sich der Zustand ändert. Und er schließt mit einem Ergebnis: Verschränkung E und lokale Konsistenz C sind für reine Zustände exakt komplementär, ihre Summe ist eins. Bei Rauschen gilt nur noch E + C ≤ 1. Die Lücke ist klassische Unsicherheit — Information, die lokal fehlt, ohne in der Korrelation aufzutauchen. In einem verrauschten Netz geht Konsistenz verloren, ohne dass jemand davon profitiert.
Bemerkenswert dabei: Die Leitfrage stammt aus meiner Diplomarbeit von 1986 — „Lokale und globale Information in verteilten Systemen". Damals ging es um Prozessornetze, heute um Quantenknoten. Die Frage ist dieselbe geblieben.
Und damit schließt sich der Kreis auf unerwartete Weise. Damals lautete die Antwort: Die Konsistenz zwischen lokaler und globaler Information ist durch die Lichtgeschwindigkeit begrenzt. In der Quantenmechanik ist sie ebenfalls begrenzt — aber durch die Verschränkungsentropie. Die klassische Schranke ist zeitlich: Die Information existiert, sie ist nur noch nicht hier, und Warten hilft. Die Quantenschranke ist strukturell: Die Information existiert lokal überhaupt nicht, und kein Warten erzeugt sie. Die Frage von 1986 wurde nicht anders beantwortet — sie wurde zweimal beantwortet.
Dieser Beitrag ist ein Fundament, noch keine ausgeführte Argumentation. Der Abschnitt wird schrittweise wachsen.
→ Zum Artikel: Where the Research Areas Converge
 Druckversion
