
QWeb © Research
 LinkedIn-Artikel: Vom Parallelrechner zum Parallel-Quantum-Computing und dem 'QWeb ©'
Vom Parallelrechner zum Parallel-Quantum-Computing und dem 'QWeb ©'
(From parallel computing to parallel quantum computing – and the “QWeb ©")
So wie der PC und das Internet einst die Vorherrschaft der Mainframe-Ära in Frage stellten, ohne sie jedoch überflüssig zu machen, wird das fehlertolerante verteilte Quanten-computing (DQC) das heutige, auf Hyperscaler ausgerichtete Modell herausfordern.
Die Idee dahinter: Anstatt einen immer größeren, zentralisierten Quantencomputer zu bauen, verbindet man viele kleinere Quantenprozessoren über quantenmechanische und klassische Kanäle zu einem skalierbaren System. Je größer ein einzelner Chip wird, desto mehr gerät er in Konflikt mit sich selbst – Qubits interferieren miteinander, und der Kühl- und Verdrahtungsaufwand steigt exponentiell an. Ein Netzwerk vermeidet dies: Skalierung in die Breite statt in die Höhe.
Die zentrale Herausforderung: Wie korrigiert man Fehler, wenn eine Berechnung über mehrere verrauschte, miteinander verbundene Module läuft? Jüngste Simulationen zeigen, dass die Fehlerraten in einigen Fällen um eine Größenordnung sinken, und im Jahr 2025 lief erstmals ein verteilter Quantenalgorithmus über photonisch verbundene Module. Das macht DQC zu einem der vielversprechendsten Wege hin zum fehlertoleranten Quanten-computing.
Genau diesen Wandel fasse ich mit dem Begriff “QWeb ©" zusammen:
Peripherie statt Zentrum, Netzwerk statt Monolith – eine Zukunft, in der Rechenleistung dezentral entsteht und nicht nur in den Rechenzentren einer Handvoll Hyperscaler.
Die Zukunft rechnet verteilt.
#QuantumComputing
~ ~ ~
Distributed Quantum Computing (Parallel-Quantum-Computing) auf Wikipedia:
Originalliteratur:
- Main et al. (2025): Distributed quantum computing across an optical network link – Nature 638, 383–388
- University of Oxford (2025): First distributed quantum algorithm brings quantum supercomputers closer – Pressemitteilung
Ich habe damit als erster weltweit (!) den Begriff "QWeb ©" geprägt und postuliert und am 1. Juli 2026 auf LinkedIn erstmals veröffentlicht und über das Internet Archive und qweb-quantum.com dokumentiert, um damit die These zu bezeichnen, dass fehlertolerantes ver-teiltes Quantencomputing die heutigen Hyperscaler-Strukturen relativieren wird – ähnlich wie einst PC und Internet die Mainframes zurückgedrängt haben.
Der LinkedIn-Artikel ist in englischer und deutscher Sprache verfasst.
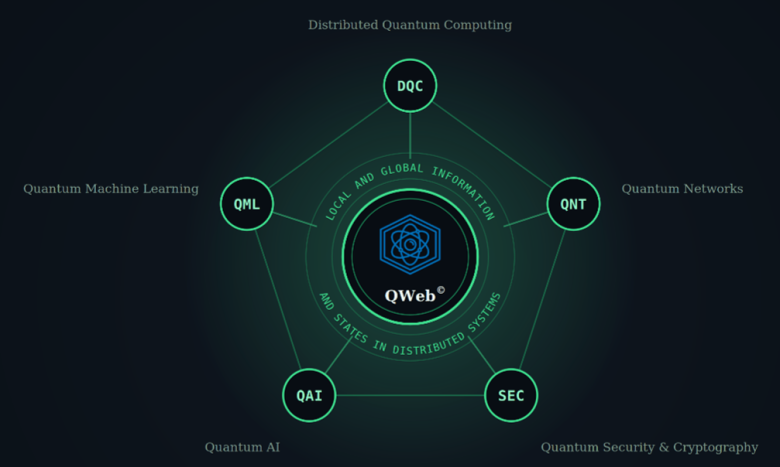 QWeb © Research
Ramon Schweiss – Gründer von QWeb © Research
Forschungsschwerpunkte: Die Entwicklung vom klassischen verteilten Rechnen über Distributed Quantum Computing (DQC) hin zu QWeb ©, einem weltweit vernetzten Quanteninternet. Die Arbeit baut auf Meilensteinen des Fachgebiets auf, darunter der ersten experimentellen Demonstration verteilter Quantenalgorithmen durch Forschende in Oxford (Nature, 2025). Daraus entsteht ein konzeptioneller Rahmen für eine quantennative Internet-Architektur. Heutige DQC-Experimente verbinden zwei Module, die wenige Meter voneinander entfernt auf einem Labortisch stehen. QWeb © fragt, was sich ändern muss, damit aus einer Demonstration eine Architektur wird. Die These: Die Antwort ist keine größere Maschine, sondern eine grundlegend andere Struktur.
Mein Team:
- Venkateswaran Ramamurthy, Krea University, Indien
- Daniel Hug, MSc Physics ETH Zürich, MBA, PMP. Er war bei UBS, Credit Suisse und SIX tätig und hat qubit-lab.ch gegründet (Quantum Computing for Financial Services).
- Dr. Johannes Voit war Leiter Interne Modelle und Konzernleiter
Nachhaltigkeitsmanagement beim DSGV.
Heute ist er Keynote-Speaker, Fachreferent und Coach für Nachhaltigkeit, Risikomanagement, Regulierung, Resilienz und Entscheidungsfindung sowie Fellow der Forschungsstelle Nachhaltigkeit an der Hochschule für Finanzwirtschaft und Management.
Partner und Netzwerk:
- IBM Quantum
- LRZ Quantum Integration Centre (QIC) und meine Alma Mater, die TU München
- IQM Quantum Computers (Finnland), seinem Entwickler-Team und der Quanten-Cloud-Plattform IQM Resonance
Seit dem NASDAQ-IPO bin ich Aktionär von IQM

Über Forschung, Team und Partner bei QWeb © Research
Auf Deutsch und Englisch
QWeb_C_Research_Steckbrief_DE_Profile_EN[...]
PDF-Dokument [239.0 KB]
Mathematische Grundlagen (Mathematical Foundations)
Zum Einstieg
Einige kurze Artikel, in einer Reihenfolge, die aufeinander aufbaut
Niemand würde heute erklären, wie ein gewöhnlicher Rechner funktioniert, indem er bei der Physik des Transistors beginnt. Das ist vollkommen richtig — und der falsche Einstieg. Stattdessen greift man zur booleschen Algebra, nicht weil die Halbleiterphysik aufgehört hätte zu gelten, sondern weil sie aufgehört hat, die Ebene zu sein, auf der sich Nützliches sagen lässt.
Beim Quantencomputing besteht dasselbe Problem, nur ist es dort ungelöst. Erklärungen beginnen bei der Superposition, bei Hilberträumen, bei „0 und 1 zugleich" — alles zutreffend, alles verfrüht, und alles lässt den Leser nicht klüger zurück in der Frage, wozu die Maschine eigentlich gut ist.
Diese Beiträge versuchen die andere Reihenfolge. Sie lassen sich einzeln lesen, sind aber in dieser Folge entstanden. Ein fünfter schließt sich an, für alle, die danach noch eine Ebene tiefer möchten.
Zuerst — The Camshaft Problem: What a Quantum Computer Actually Is
Wozu ist die Maschine gut? Der Beitrag lässt einen Quantenrechner das Einfachste versuchen, was ein Rechner je tut — eins und eins addieren — und fragt dann, worin seine Stärke tatsächlich liegt.
Räumt auf mit: der Vorstellung, ein Quantenrechner sei ein schnellerer Rechner. Er ist ein anderer.
Dann — What a Qubit Actually Is
Womit rechnet die Maschine? Ein Qubit hält einen Zustand, und dieser ist eine Richtung, kein Wert. Messen heißt, eine Achse zu wählen und entlang ihr zu fragen.
Räumt auf mit: der Vorstellung, ein Qubit sei „0 und 1 zugleich". Die Zufälligkeit gehört zur Frage, nicht zum Qubit.
Weiter — What Entropy Actually Measures
Welche Größe steuert das alles? Die Entropie misst, wie viel man nicht weiß — und in der Quantenmechanik kann ein Teil weniger wissen als das Ganze, zu dem er gehört.
Räumt auf mit: der Vorstellung, Entropie sei Unordnung. Ein gemischtes Kartenspiel ist nicht ungeordnet; es ist einem unbekannt.
Und schließlich — What a Hamiltonian Actually Says
Was bestimmt, wie sich das System verhält? Ein Hamilton-Operator ist eine Liste von Wünschen, und der Grundzustand der beste Kompromiss zwischen ihnen. Verschränkung steht nirgends darin — sie entsteht, wenn die Wünsche sich widersprechen.
Räumt auf mit: der Vorstellung, es handle sich um „den Operator für die Gesamtenergie". Zutreffend, und die falsche Ebene zum Anfangen.
Eine Ebene tiefer
Die Beiträge oben kommen fast ohne Rechnung aus. Dieser nicht — er setzt den Hamilton-Artikel voraus und geht der Frage nach, was ein Quantenrechner eigentlich tut, wenn im Schaltbild „X anwenden" steht.
Die Antwort: Ein Gatter ist kein Grundbaustein. Es ist ein Hamilton-Operator, den man eine genau bemessene Zeit lang einschaltet. Der Term bestimmt die Drehachse, die Dauer den Winkel. Woraus unter anderem folgt, dass Warten ebenfalls eine Operation ist — der eigene Term eines Qubits läuft weiter, ob man will oder nicht.
Und weil ein Mikrowellengenerator kein σₓ erzeugt, sondern ein schwingendes Feld, entscheidet die genaue Frequenz darüber, ob das Gatter überhaupt zustande kommt. Bei dreifacher Verstimmung kommt derselbe Puls nie über eine Chance von eins zu zehn hinaus.
Kalibrierung ist keine Feinpolitur. Sie entscheidet, ob das Gatter überhaupt wirkt, also ob das Qubit umklappt oder nicht.
Zum Weiterlesen
Einige weitere Beiträge für alle, die über die Grundlagen hinausmöchten. Sie setzen etwas mehr voraus.
The Analogy That Almost Works — warum jedes klassische Bild der Verschränkung irgendwann scheitert und an welcher Stelle genau. Der Bruchpunkt ist das Bellsche Theorem.
Whose Measurement Came First? — zwei weit entfernte Messungen an einem verschränkten Paar können von verschiedenen Beobachtern unterschiedlich geordnet werden, und die Vorhersagen stimmen dennoch überein.
Was ist ein Tensor? — auf Deutsch. Vom Kronecker-Produkt zu den Tensor-Netzwerken. Der Begriff bedeutet in Physik, Mathematik und maschinellem Lernen Verschiedenes, und das Vermengen stiftet einige Verwirrung.
Und danach?
Die Forschungsbeiträge auf QWeb bauen auf diesen Grundlagen auf, statt sie zu wiederholen. Der Entropie-Artikel ist dabei das Scharnier: Die Größe, die er einführt, zieht sich durch alles Weitere — ob ein Zustand über mehrere Maschinen verteilt werden kann, was diese Verteilung kostet, und warum ein verteilter Quantenrechner schwerer zu bauen ist als ein verteilter klassischer.
Die Rechnungen dahinter sind öffentlich einsehbar: github.com/RamonSchweiss/qweb-research. Stimmt eine Zahl dort nicht mit einem Artikel überein, ist der Artikel falsch — dann bitte ich um Nachricht.
 Das Nockenwellen-Problem: Was ein Quantencomputer wirklich ist
(im Original: „The Camshaft Problem: What a Quantum Computer Actually Is")
Die meisten Erklärungen zum Quantencomputing beginnen mit „Ein Qubit kann 0, 1 oder beides gleichzeitig sein" — und verraten nie, wofür das eigentlich gut sein soll. Genau das ist der Nockenwellen-Fehler: eine zutreffende Aussage über den Motor, erzählt jemandem, der bloß wissen will, wann er den Wagen zur Inspektion bringen muss.
Deshalb habe ich eine andere Art von Einführung geschrieben. Sie beginnt mit der kleinsten Aufgabe, die ein Computer je zu erledigen hat — der Addition von 1 + 1 — und schaut dabei zu, wie ein Quantencomputer sich daran versucht. Das Ergebnis überrascht: Er löst sie dramatisch schlechter. Und zwar mit Absicht. Genau diese Tatsache erweist sich als der denkbar deutlichste Wegweiser dahin, wofür Quantencomputer wirklich gemacht sind.
→ Zum Artikel: https://qweb-quantum.com/blog/camshaft-problem-what-is-a-quantum-computer
 Was ein Qubit tatsächlich ist
(im Original: „What a Qubit Actually Is")
Niemand würde heute erklären, wie ein Rechner funktioniert, indem er bei der Physik des NPN-Übergangs im Transistor beginnt. Das ist vollkommen richtig — und der falsche Einstieg. Stattdessen greift man zur booleschen Algebra, nicht weil die Halbleiterphysik aufgehört hätte zu gelten, sondern weil sie aufgehört hat, die Ebene zu sein, auf der sich Nützliches sagen lässt.
Beim Quantencomputing besteht dasselbe Problem, nur ist es dort ungelöst. Die Superposition ist der Halbleiterübergang dieses Themas, und fast jede Erklärung beginnt mit ihr.
Dieser Beitrag versucht eine andere Reihenfolge.
Der Satz, der in die Irre führt. „Ein klassisches Bit ist 0 oder 1, ein Qubit beides zugleich." Der Satz ist eigentlich nicht falsch, aber er pflanzt ein Bild ein — eine kleine Schachtel mit zwei Werten darin. Und von dort ist es nur ein kurzer Weg zu „ein Quantenrechner probiert alle Antworten gleichzeitig durch", wo die meisten populären Darstellungen enden.
Es gibt einen Test, der die Sache entscheidet: Hielte ein Qubit wirklich beide Werte, und könnte man sie auslesen, wäre Quantencomputing trivial. Aufgabe laden, alle Antworten ablesen, fertig. Die gesamte Schwierigkeit des Feldes — jeder Algorithmus, jedes kunstvolle Stück Interferenztechnik — besteht darin, dass man es eben nicht kann. Das Bild ist also nicht unvollständig, sondern falsch.
Die richtige Ebene. Ein Qubit hält einen Zustand, und dieser ist bestimmt. Er ist nicht unentschieden, nicht verschmiert, nicht zweierlei. Der Unterschied zum Bit liegt nicht in der Menge, sondern in der Art: Der Zustand ist eine Richtung, kein Wert.
Messen heißt dann, eine Achse zu wählen und entlang ihr zu fragen. Fragt man entlang der Richtung, in die der Zustand zeigt, ist die Antwort sicher. Fragt man quer dazu, bekommt man eine faire Münze. Je schräger die Frage, desto unsicherer die Antwort.
Dabei geschieht mit dem Zustand Verschiedenes. Entlang seiner eigenen Richtung gemessen bleibt er unverändert — man kann beliebig oft fragen und bekommt stets dasselbe. Quer dazu gemessen wird er dagegen zerstört: Die Messung zwingt das Qubit auf eine der beiden Achsenrichtungen, und dort bleibt es. Die faire Münze zeigt sich also nur beim ersten Mal. Um die Verteilung überhaupt zu sehen, braucht man viele gleich präparierte Qubits, jedes einmal gefragt — nicht eines mehrfach.
Daraus folgt der Satz, der das häufigste Missverständnis auflöst: Die Zufälligkeit gehört zur Frage, nicht zum Qubit.
Und woher kommt dann die Leistung? Nicht daher, dass ein Qubit viele Werte hielte. Sondern daher, dass sich die Richtungen mehrerer Qubits auf eine Weise verbinden lassen, die kein Satz unabhängiger Bits nachbildet — und dass sich die falschen Möglichkeiten gegenseitig auslöschen lassen, bevor überhaupt gemessen wird. Das ist Interferenz, und das ist der eigentliche Mechanismus.
Weniger aufregend als „probiert alles gleichzeitig", aber erheblich brauchbarer: Ein Quantenrechner erkundet nicht alle Möglichkeiten. Er sorgt dafür, dass die falschen sich aufheben.
Der Beitrag kommt übrigens durch sieben Abschnitte, ohne das Wort Superposition ein einziges Mal zu verwenden. Das war die Absicht.
→ Zum Artikel: What a Qubit Actually Is
 Was Entropie tatsächlich misst
(im Original: „What Entropy Actually Measures")
Die Entropie schleppt für eine Größe mit einzeiliger Definition erstaunlich viel Gepäck mit sich. Sie kommt an in Begleitung von Wärmekraftmaschinen, dem Zeitpfeil, dem Wärmetod des Universums und einem vagen Gefühl, dass die Dinge zerfallen. Nichts davon hilft, wenn sie in einer Formel über Qubits auftaucht.
Also nicht Unordnung, sondern Unwissen. Ein gemischtes Kartenspiel ist in keinem Sinn ungeordnet, den ein Physiker verteidigen würde — jede Anordnung ist so gültig wie jede andere. Was das gemischte Spiel ist, ist einem unbekannt. Und genau diese Größe misst die Entropie.
Warum die Formel so aussieht, wie sie aussieht. Das Minuszeichen und der Logarithmus wirken willkürlich, bis man fragt, was ein solches Maß erfüllen müsste. Zwei Forderungen legen es beinahe fest.
Eine Gewissheit muss null zählen — und log₂1 = 0 leistet genau das. Und Information aus unabhängigen Quellen muss sich addieren, während sich Wahrscheinlichkeiten multiplizieren. Gebraucht wird also eine Funktion, die aus Multiplikation Addition macht. Es gibt nur eine.
Wohin die Bits gehen. Das ist keine Buchhaltung: Eine Quelle mit Entropie S lässt sich auf S Bit je Zeichen komprimieren und keinen Deut weiter. Tausend faire Münzwürfe brauchen tausend Bit. Tausend Würfe einer Münze, die zu 99 Prozent Kopf zeigt, passen in 81 Bit — dieselben tausend Ereignisse, ein Zwölftel des Speichers, weil die meisten vorhersagbar waren. Jedes Kompressionsprogramm lebt davon.
Und dann die Stelle, die mich beim Durchrechnen überrascht hat. Klassisch gilt: Ein Teil kann nie weniger bekannt sein als das Ganze. Weiß man genau, was im Umschlag steckt, weiß man auch, was jedes einzelne Bit darin ist. Anders geht es nicht.
Die Quantenmechanik hält sich schlicht nicht daran. Ein Bell-Paar hat die Entropie 0 — nichts daran ist unbekannt, die Beschreibung ist vollständig und exakt. Jedes einzelne Qubit darin hat die Entropie 1, also maximal, eine faire Münze.
Der Teil trägt mehr Entropie als das Ganze. Klassisch ein Widerspruch, hier schlicht das, was Verschränkung ist.
Und wohin ist die Information verschwunden? Nirgendwohin. Sie ist nicht versickert und steckt auch nicht in einer verborgenen Größe, die noch niemand gefunden hat. Sie steckt in der Paarung. Fragt man „was tut dieses Qubit?", gibt es wirklich keine Antwort — nicht weil sie verborgen wäre, sondern weil die Frage am falschen Gegenstand ansetzt. Fragt man dagegen „stimmen diese beiden überein?", ist die Antwort exakt und sicher.
Wird S auf diese Weise berechnet, für einen Teil eines größeren Systems, heißt es Verschränkungsentropie. Es misst, wie viel vom Ganzen in die Beziehung gewandert ist.
→ Zum Artikel: What Entropy Actually Measures
 Was ein Hamilton-Operator tatsächlich sagt
(im Original: „What a Hamiltonian Actually Says")
Die Lehrbücher beginnen mit: der Operator, der die Gesamtenergie eines Systems darstellt. Jedes Wort daran ist richtig. Und es hilft ungefähr so weit wie die Auskunft, ein Transistor sei ein Halbleiterbauelement mit drei Anschlüssen, wenn man Software schreiben möchte.
Die brauchbare Lesart lautet anders. Ein Hamilton-Operator ist eine Liste von Wünschen. Jeder Term sagt, was er gern hätte; niedrigere Energie bedeutet mehr von dem, was dieser Term will. Und der Grundzustand ist der beste Kompromiss, der sich zwischen allen finden lässt.
Ein Punkt zur Begrifflichkeit, weil die lockere Formulierung in die Irre führen kann: Der Hamilton-Operator ist nicht die Energie. Er ist ein Operator — bei Qubits eine Matrix —, und die Energien sind das, was aus ihm herausfällt. Drei Dinge sind auseinanderzuhalten: der Operator selbst, seine Eigenwerte als die möglichen Energien, und der Erwartungswert in einem bestimmten Zustand als der Mittelwert, den man messen würde.
Daraus folgt eine Forderung, die keine Formsache ist: Der Operator muss hermitesch sein, also gleich seiner konjugiert transponierten Matrix. Nur das garantiert reelle Eigenwerte — und eine Messung kann keine komplexe Zahl liefern.
Für Qubits lassen sich die Terme wie Sätze lesen:
- Der Term −Z⊗Z sagt: stimmt miteinander überein.
- Der Term −X sagt: zeige nach x — und hat zu 0 und 1 überhaupt nichts zu sagen.
Und nun das Interessante. Setzt man beide zusammen, lassen sie sich nicht gleichzeitig erfüllen: Übereinstimmung heißt, dass jedes Qubit entlang z liegt, und das ist der schlechteste Ort für einen Term, der x will. Der Grundzustand muss also verhandeln.
Das Ergebnis dieser Verhandlung ist kein Kompromiss im gewöhnlichen Sinn. Es ist ein verschränkter Zustand.
Und genau das würde ich jedem zeigen, der in das Thema einsteigt: Im Hamilton-Operator kommt Verschränkung nicht vor. Er besteht ausschließlich aus Termen, die auf ein oder zwei Qubits wirken. Verschränkung ist kein Bestandteil, sondern das, was herauskommt, wenn die Bestandteile sich widersprechen. Dreht man die Feldstärke hoch, verschwindet sie wieder — weil dann ein Term allein gewinnt und nichts mehr zu verhandeln bleibt.
Der Artikel erklärt außerdem, warum Quantengatter keine Grundbausteine sind, sondern Hamilton-Operatoren, die eine bestimmte Zeit lang laufen — und warum es entscheidet, ob die Terme lokal oder global sind. Letzteres bestimmt nämlich, ob sich überhaupt optimieren lässt.
→ Zum Artikel: What a Hamiltonian Actually Says
 Wie ein Gatter tatsächlich entsteht
(im Original: „How a Gate Is Actually Made")
Schaltbilder zeichnen Quantengatter als Kästchen auf einer Leitung, als hätte die Hardware sie einfach. Hat sie nicht.
Ein Gatter ist ein Hamilton-Operator, den man eine genau bemessene Zeit lang einschaltet. Eine einzige Regel deckt alle ab: U = exp(−iHt/ℏ). Der Term bestimmt die Drehachse, die Dauer bestimmt den Winkel. Eine eigene Schicht von „Gattern" gibt es nicht — es gibt einen Hamilton-Operator, und es gibt die Frage, wie lange man ihn laufen lässt.
Daraus folgt zweierlei, und das Erste überrascht.
Warten ist eine Operation. Ein Qubit, das man in Ruhe lässt, hat weiterhin seinen eigenen σᵤ-Term laufen — der ist eine Eigenschaft des Bauteils und lässt sich nicht abschalten. Die relative Phase dreht sich also weiter, und nach einem bestimmten Zeitraum ist genau das Z-Gatter ausgeführt. Leerlauf ist nicht neutral; es ist ein Gatter, das angewandt wird, ob man es wollte oder nicht. Deshalb verfolgen Quantencompiler die Wartezeiten sorgfältig.
Und ein Mikrowellengenerator erzeugt keinen σₓ-Term. Er erzeugt ein schwingendes Feld. Der Schritt vom einen zum anderen ist der Ort, an dem die Physik des Gatterentwurfs tatsächlich stattfindet: Man wechselt in ein mitrotierendes Bezugssystem, in dem einer der beiden gegenläufigen Anteile stillsteht, während der andere mit doppelter Frequenz schwingt. Über jeden realistischen Puls mittelt sich der schnelle Anteil weg — das ist die Rotating Wave Approximation.
Was übrig bleibt, hängt von der Verstimmung ab. Trifft man die Resonanz genau, verschwindet der σᵤ-Term vollständig und die Drehung ist sauber. Trifft man sie nicht, überlebt er.
Und das ändert, was Kalibrierung eigentlich ist. Ich habe den vollen zeitabhängigen Hamilton-Operator simuliert, ohne jede Näherung. Bei Resonanz führt der Puls das Qubit exakt von |0〉 nach |1〉 — das NOT-Gatter. Bei dreifacher Verstimmung kommt derselbe Puls nie über eine Chance von eins zu zehn hinaus, gleich wie lange er läuft. Die Obergrenze folgt der Formel Ω²/(Ω²+Δ²): Schon eine Verstimmung in Höhe der Rabi-Frequenz kostet die Hälfte.
Der Grund ist im effektiven Operator ablesbar. Außerhalb der Resonanz dreht der Zustand um eine gekippte Achse und beschreibt damit einen kleineren Kreis auf der Bloch-Kugel. Er dreht sich durchaus — er erreicht den gegenüberliegenden Pol nur nie, weil der Pol nicht auf seinem Kreis liegt.
Kalibrierung ist also keine Feinpolitur. Sie entscheidet, ob das Gatter überhaupt wirkt, also ob das Qubit umklappt oder nicht.
→ Zum Artikel: How a Gate Is Actually Made
 Die Mathematik hinter dem Quantencomputing
(im Original: „The Math behind Quantum Computing")
Jeder Computer, den wir je benutzt haben, beruht auf der Booleschen Algebra: zwei Werte, eine Handvoll Gatter, ein paar Verknüpfungsregeln. Daraus entsteht der Halbaddierer, daraus die Arithmetik, daraus die von-Neumann-Architektur — und schließlich die Programmiersprachen, mit denen wir diese Maschinen steuern. Bis John Backus, der Schöpfer von Fortran, in seiner Turing-Award-Vorlesung 1977 ausgerechnet jenen Stil angriff, den er selbst mitgeprägt hatte: „Can Programming Be Liberated from the von Neumann Style?"
Was aber tritt im Quantencomputer an die Stelle der Booleschen Algebra? Die Antwort ist keine Erweiterung, sondern ein Austausch: lineare Algebra über komplexen Vektorräumen. Ein Qubit ist kein Wert, sondern ein Vektor. Ein Gatter ist keine Wahrheitstabelle, sondern eine unitäre Matrix. Und Rechnen heißt: multiplizieren.
Die Präsentation führt Schritt für Schritt von der Schulmathematik zu jener Algebra, auf der ein Qubit tatsächlich läuft. Sie erklärt, was ein Tensorprodukt wirklich ist — und was es nicht ist, denn mit dem Tensor der Relativitätstheorie hat es wenig zu tun. Sie zeigt, warum n Qubits 2n Zahlen zur Beschreibung brauchen, und warum diese Exponentialfunktion keine Metapher ist, sondern schlicht die Dimension des Zustandsraums.
Der schönste Befund unterwegs: Verschränkung ist mathematisch nichts Exotisches, sondern das Scheitern der Tensorfaktorisierung — ein Zustand ist genau dann verschränkt, wenn er sich nicht mehr in zwei getrennte Vektoren zerlegen lässt. Und die Boolesche Algebra? Sie verschwindet nicht, aber sie rückt an den Rand: Sie regiert nur noch, was hineingeht und was herauskommt — die Messung und das reversible Einbetten klassischer Logik. Sie ist die Schnittstelle, nicht der Motor.
Am Ende schließt sich der Kreis zu Backus. Ein Quantenschaltkreis kennt keinen Speicher, keine Zuweisung, keine schrittweise Zustandsänderung. Er ist Komposition von Funktionen mit einer echten Algebra dahinter — genau der funktionale Stil, den Backus 1977 forderte. Niemand hat das so geplant; die Physik ließ keine andere Wahl.
→ Zum Artikel: The Math behind Quantum Computing
Was ist ein Tensor? Vom Kronecker-Produkt zu den Tensor Netzwerken
Wer im Internet nach einer Einführung sucht, gerät schnell in die Irre: Der Begriff meint in der Physik etwas anderes als im Quantencomputing — und deutschsprachiges Material, das den Bogen bis zu den Tensor Netzwerken schlägt, ist kaum zu finden.
Dieser Artikel versucht genau das.
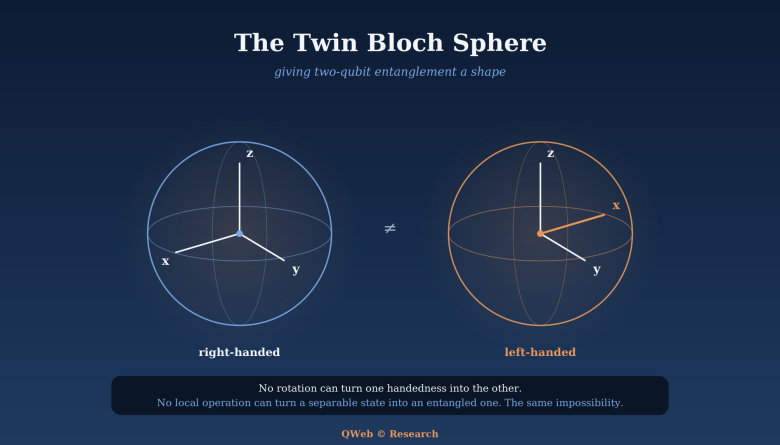 Die Zwillings-Bloch-Kugel: eine Geometrie für Verschränkung
(im Original: „The Twin Bloch Sphere: A Geometry for Entanglement")
Ein Qubit hat ein schönes Bild: einen Punkt auf einer Kugel. Zwei Qubits hatten bislang keines — und das nicht aus Mangel an Versuchen. Das Hindernis ist präzise benennbar: Spurt man ein Qubit eines maximal verschränkten Zustands aus, ist die reduzierte Dichtematrix proportional zur Einheitsmatrix. Der Bloch-Vektor hat die Länge null. Alle vier Bell-Zustände fallen damit auf dasselbe Bild zusammen — zwei Kugeln, zwei Punkte im Zentrum —, obwohl sie zueinander orthogonal sind und sich physikalisch deutlich unterscheiden.
Eine Arbeit von Stanislav Filatov und Mārcis Auziņš von der Universität Lettland aus dem Jahr 2024 findet die fehlende Struktur an einer unerwarteten Stelle: nicht in den Pfeilen, sondern in den Koordinatenachsen selbst.
Der Artikel folgt der Mathematik Schritt für Schritt. Er beginnt beim Tensorprodukt — wie ℂ² ⊗ ℂ² = ℂ⁴ die Größe des Problems festlegt (sechs reelle Parameter für einen reinen Zwei-Qubit-Zustand), und warum die Lie-Algebra-Isomorphismen spin(6) ≈ so(6) ≈ su(4) einen sechsdimensionalen reellen Raum verlangen. Zwei Bloch-Kugeln liefern genau sechs Koordinatenachsen.
Dann eine bemerkenswerte Übereinstimmung zweier voneinander unabhängiger Abzählungen: Die Zwei-Qubit-Pauli-Basis umfasst 4 × 4 = 16 Operatoren, abzüglich I⊗I bleiben 15. Und sechs Achsen spannen C(6,2) = 15 Rotationsebenen auf. Sechs dieser Ebenen liegen innerhalb einer Kugel — das sind die lokalen Rotationen, die niemals Verschränkung erzeugen können. Die übrigen neun verbinden eine Achse der einen mit einer Achse der anderen Kugel. Nur dort kann Verschränkung entstehen.
Ein eigener Abschnitt erklärt, warum die Autoren zur Geometrischen Algebra greifen: In drei Dimensionen beschreibt man eine Rotation bequem durch ihre Achse, weil jede Ebene genau eine Normale besitzt. In sechs Dimensionen versagt das — der Begriff „Rotationsachse" wird sinnlos, während der Begriff „Rotationsebene" wohldefiniert bleibt. Genau dafür liefert die Geometrische Algebra mit dem Bivektor das Vokabular.
Den Kern bildet schließlich die Händigkeit: Ein maximal verschränkter Zustand wird durch zwei Bloch-Kugeln dargestellt, deren Koordinatenachsen entgegengesetzte Händigkeit haben — die eine rechtshändig, die andere linkshändig. Warum das funktionieren kann, hat einen tiefen Grund: Keine Rotation kann Händigkeit verändern, das unterscheidet sie von einer Spiegelung. Und keine lokale Operation kann einen separablen Zustand in einen verschränkten überführen. Diese beiden Unmöglichkeiten sind dieselbe Unmöglichkeit — deshalb trägt die Geometrie.
Bemerkenswert und im Artikel ausdrücklich erwähnt: Die Autoren fanden diese Struktur nicht über die Geometrie, sondern indem sie die vier Bell-Zustände in allen drei konjugierten Basen neu aufschrieben und schauten, was gleich blieb.
Der Artikel benennt auch die Grenzen — nur reine Zustände, nur zwei Qubits, mehrere konkurrierende Ansätze — und schließt mit dem Bogen zur Ausgangsfrage meiner Artikelreihe: Wann besitzt ein Teilsystem einen eigenen Zustand? Die algebraische Antwort lautet: wenn sich der Zustand als A ⊗ B schreiben lässt. Die geometrische Antwort lautet: wenn die beiden Koordinatensysteme dieselbe Händigkeit haben. Dieselbe Tatsache in zwei Sprachen.
→ Zum Artikel: The Twin Bloch Sphere: A Geometry for Entanglement
Distributed Quantum Computing (DQC)
 Wer hat zuerst gemessen? Verschränkung und die Relativität des Kollapses
(im Original: „Whose Measurement Came First? Entanglement and the Relativity of Collapse")
Wann besitzt ein Teilchen einen eigenen Zustand — und wann existiert es nur als Teil eines größeren Ganzen? Dieser Artikel nähert sich der Frage über ein Gedankenexperiment: Zwei maximal verschränkte Qubits werden weit voneinander getrennt und quasi gleichzeitig gemessen. Wer von beiden Beobachtern hat die „erste" Messung durchgeführt und damit den Zustand des Paares festgelegt?
Die Antwort ist verblüffend: Es gibt keine. Weil die beiden Messereignisse raumartig getrennt sind, ordnen verschiedene Beobachter ihre zeitliche Reihenfolge unterschiedlich — und keine Sichtweise
ist bevorzugt. Der Artikel zeigt, warum das kein Widerspruch ist: Alle beobachtbaren Größen, insbesondere die Korrelationen der Messergebnisse, sind von der angenommenen Reihenfolge vollständig
unabhängig. Der „Kollaps" der Wellenfunktion erweist sich damit weniger als reales physikalisches Ereignis, sondern als Merkmal unserer Beschreibung.
Auf dem Weg dorthin führt der Beitrag durch die Bell-Ungleichung und den CHSH-Test (benannt nach Clauser, Horne, Shimony und Holt), erklärt die Tsirelson-Grenze und die experimentellen Schlupflöcher
samt ihrer Schließung in den lückenlosen Tests von 2015.
Abschließend wird der Bogen zu praktischen Anwendungen geschlagen — zertifizierte Zufallszahlen und geräteunabhängige Schlüsselverteilung — und zurück zur Ausgangsfrage nach lokaler und globaler Information in verteilten Quantennetzwerken:
Was verschränkte Qubits leisten — und was nicht
Verschränkte Qubits tragen eine Korrelation, die nachweislich stärker ist als alles klassisch Erklärbare: Der Bell-Test schließt aus, dass die Messergebnisse auf einer vorab vereinbarten Absprache beruhen. Darin liegt ihr kryptografischer Wert — das Paar trägt ein gemeinsames Geheimnis, das Außenstehende nicht auslesen können, weil es vor der Messung schlicht noch nicht existierte.
Zugleich verführt dieser Befund zu einem Fehlschluss. Verschränkung überträgt keine Information: Keine Handlung an einem Qubit erzeugt am anderen eine beobachtbare Änderung, und jedes darauf aufbauende Protokoll — Schlüsselverteilung, Teleportation, Entanglement Swapping — benötigt zusätzlich einen klassischen, durch die Lichtgeschwindigkeit begrenzten Kanal.
Was geteilte Verschränkung verändert, ist daher nicht die Latenzgrenze, sondern die Menge der nötigen klassischen Kommunikation: Für bestimmte verteilte Aufgaben müssen Parteien mit verschränkten Paaren nachweislich weniger klassische Bits austauschen als Parteien ohne. Die Lichtgeschwindigkeit bleibt die Untergrenze dafür, wie schnell sich Übereinstimmung in einem Netzwerk ausbreiten kann — Verschränkung senkt lediglich den Preis, sie zu erreichen.
→ Zum Artikel: Whose Measurement Came First? Entanglement and the Relativity of Collapse
 Wie Verschränkung den Preis der Übereinstimmung senkt
(im Original: „How Entanglement Lowers the Price of Agreement")
Jedes verteilte System zahlt dieselbe Rechnung: Seine Knoten halten lokale Information, seine Aufgaben verlangen global konsistente Antworten — und die Lücke dazwischen muss mit Kommunikation bezahlt werden, die nie schneller als das Licht reist. Dieser Artikel fragt, was Verschränkung an dieser Rechnung ändert, und was nicht.
Die Antwort beginnt mit den harten Grenzen: Verschränkung überträgt selbst keinerlei Information (No-Signalling), und für den reinen Datentransport hilft sie höchstens um den Faktor zwei (Holevo-Schranke, Superdense Coding). Die eigentliche Bühne ist die Kommunikationskomplexität (Yao 1979) — die Frage, wie viele Bits zwei Parteien mindestens austauschen müssen, um eine gemeinsame Funktion ihrer verteilten Eingaben zu berechnen. Hier zeigt der Artikel den Bogen von der ersten Ein-Bit-Einsparung (Cleve–Buhrman 1997) über quadratische bis hin zu bewiesenen exponentiellen Vorteilen (Raz 1999, Hidden Matching).
Den Höhepunkt bildet das Mermin–Peres-„Magic-Square"-Spiel (Das Mermin-Peres Magic Square auf Wikipedia: https://en.wikipedia.org/wiki/Quantum_pseudo-telepathy und auf YouTube: https://www.youtube.com/watch?v=ahsaT6y7Zig): eine Aufgabe, die zwei Parteien mit geteilten Bell-Paaren in jeder Runde sicher gewinnen — ganz ohne Kommunikation —, während jede klassische Strategie beweisbar an mindestens einer von neun Kombinationen scheitert. Zugleich benennt der Artikel die Grenzen: Für manche Funktionen (etwa das innere Produkt) verschwindet der Vorteil vollständig, und die Latenzgrenze c bleibt in jedem Fall unangetastet.
Der Schluss spannt den Bogen zu meiner Diplomarbeit von 1986 („Sprachkonzepte zur Darstellung lokaler und globaler Information für die Ablaufsteuerung von parallelen Prozessen"): Deren These — vollständige Konsistenz lokaler und globaler Information ist wegen c unerreichbar — wird durch die Quantenmechanik nicht widerlegt, sondern verfeinert. Verschränkung senkt die Kosten der Konsistenz, für manche Aufgaben exponentiell, für einige auf null — die Lichtgeschwindigkeit als Untergrenze bleibt.
→ Zum Artikel: How Entanglement Lowers the Price of Agreement
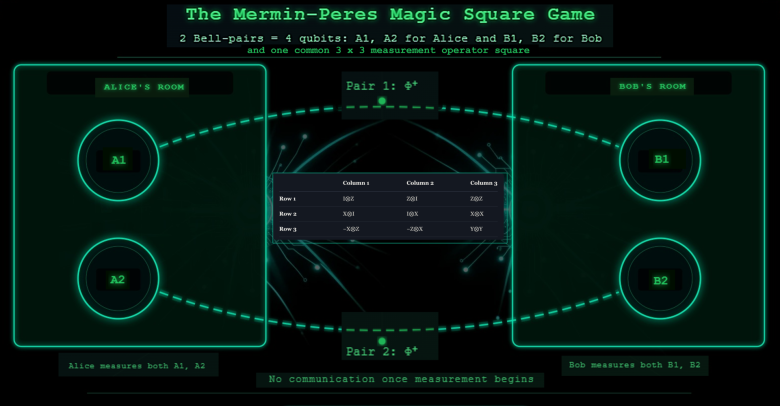 Das Mermin–Peres Magic Square Game und die Implementierung in Qiskit
(im Original: „The Mermin–Peres Magic Square Game")
Können zwei Parteien, die nicht miteinander kommunizieren dürfen, sich trotzdem so abstimmen, als hätten sie sich auf einen unmöglichen Antwortschlüssel geeinigt? Klassisch lautet die Antwort nein — ein einfaches Paritätsargument zeigt, dass jede vorab festgelegte 3×3-Tabelle bei mindestens einer von neun möglichen Abfragen scheitern muss. Dieser Artikel baut das Mermin-Peres Magic Square Game Schritt für Schritt auf: von der klassischen Unmöglichkeit über zwei geteilte verschränkte Qubit-Paare und die neun quantenmechanischen Messoperatoren, die das Spiel realisieren, bis zur operatoralgebraischen „Magie" — zwei bewusst mit Vorzeichen versehene Zellen —, die es zwei Spielern erlaubt, jede einzelne Runde mit Sicherheit zu gewinnen. Den Abschluss bildet der Bezug zum Kochen-Specker-Theorem über Quantenkontextualität.
→ Zum Artikel: The Mermin–Peres Magic Square Game
→ Zur Implementierung: The Mermin–Peres Magic Square Game in Qiskit
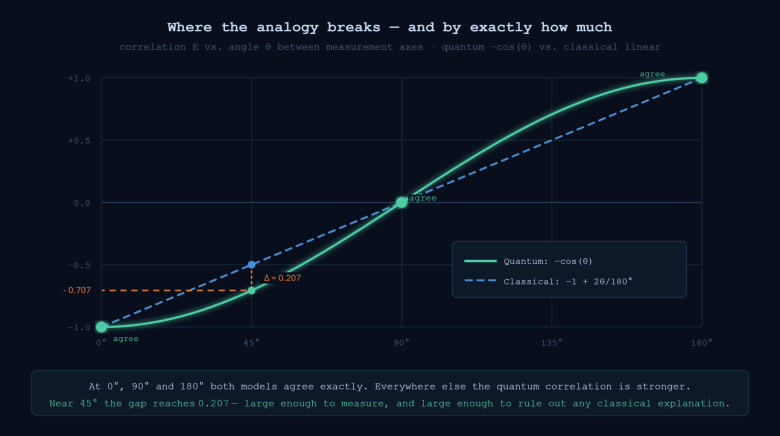 Die Analogie, die fast funktioniert: Warum klassische Bilder der Verschränkung zerbrechen
(im Original: „The Analogy That Almost Works: Why Classical Pictures of Entanglement Break")
Zwei gemeinsam angestoßene Kreisel behalten ihre Achsenausrichtung, wie weit sie sich auch voneinander entfernen. Zwei synchron angestoßene Pendel schwingen dauerhaft in derselben Ebene. Öffnet man in Wien eine von zwei Handschuhschachteln, weiß man augenblicklich, was in Tokio liegt. Solche Bilder lassen Verschränkung gewöhnlich erscheinen — und sie sind alles andere als naiv. Es ist genau die Position, die Einstein 1935 im EPR-Aufsatz vertrat.
Ihre Hartnäckigkeit rührt daher, dass sie über weite Strecken nicht bloß ungefähr, sondern exakt zutreffen. Messen beide Seiten entlang derselben Achse, gibt das klassische Bild die Quantenmechanik perfekt wieder. Bei senkrechten Achsen ebenso. Und beide Bilder verbieten gleichermaßen, ein Signal zu übertragen — jede Seite sieht für sich nur Zufall.
Bells Einfall bestand darin, nach den Winkeln zu fragen, die niemand geprüft hatte. Bei 45° sagt ein Modell mit vorab verabredeten Werten eine Korrelation von −0,50 voraus, die Quantenmechanik dagegen −0,707. Bemerkenswert ist dabei die Richtung der Abweichung: Die tatsächliche Korrelation ist die stärkere. Keine noch so raffinierte Vorabverabredung kann so eng koordinieren, wie die Natur es tut.
Der Artikel verfolgt diese Lücke von der Kurve über die CHSH-Zahl bis zur Messung im Labor — klassisch höchstens 2, quantenmechanisch 2√2 ≈ 2,83, seit 1972 gemessen und 2015 lückenlos bestätigt. Er erklärt, warum sich das Pendel nicht reparieren lässt: nicht weil es zu einfach wäre, sondern weil es zu bestimmt ist. Ein Pendel besitzt eine Schwingungsebene, auch wenn niemand hinsieht; ein Spin besitzt keinen festen Wert entlang aller Achsen zugleich. Hier schließt sich der Bogen zum Mermin-Peres-Quadrat, das genau dies vorführt.
Zwei weitere Abschnitte grenzen ab: Robert Spekkens' Spielzeugtheorie von 2007 als raffiniertester klassischer Versuch — sie reproduziert erstaunlich viel, kann aber die Bell-Ungleichung nicht verletzen. Und die sogenannte „klassische Verschränkung" in der Optik, mathematisch dieselbe Nicht-Faktorisierbarkeit, physikalisch aber ohne jede Nichtlokalität.
Das Fazit ist kein Abgesang auf die Analogien. Sie sind die beste klassische Näherung, die es gibt — und zu wissen, wo genau sie scheitern, ist lehrreicher, als sie nie versucht zu haben.
→ Zum Artikel: The Analogy That Almost Works
 Was Autonomie wirklich abnimmt
(im Original: „What Autonomy Actually Removes")
2004 sagten Barbara Kraus und Ignacio Cirac etwas Überraschendes voraus: Zwei Atome, die einander nie begegnen, nie wechselwirken und nie gemessen werden, geraten in einen verschränkten Zustand, wenn man beide in gequetschtes Licht taucht. Und sie bleiben darin — nicht weil etwas nachsteuert, sondern weil die Physik sie dorthin trägt.
Es hat zweiundzwanzig Jahre gedauert. 2026 haben es zwei Gruppen unabhängig voneinander gezeigt, beide mit supraleitenden Qubits, beide Arbeiten erschienen gemeinsam in Physical Review X. Verschränkung im Selbstlauf, ohne einen einzigen getakteten Steuerpuls.
Mich hat eine engere Frage interessiert als die, die in den Meldungen stand. Meine eigene Arbeit misst, wie lange die Aufteilung einer verteilten Rechnung brauchbar bleibt, bevor der Zustand darunter weggewandert ist. Hilft ein Link, der sich selbst nachfüllt, dagegen?
Drei Befunde.
Die Treue ist bei (1 + C) / 2 gedeckelt — keine Annahme über das Rauschen, sondern eine Schranke: über viertausend zufällige Zweiqubit-Zustände überschreitet sie keiner. Damit liegen die beiden Verbindungen bei 0,55 und 0,74.
Beide liegen unter der Hashing-Schwelle von 0,811, ab der Einweg-Destillation überhaupt etwas abwirft. Es bleibt nur die Rekursion, und jede ihrer Runden ist ein klassischer Zwei-Wege-Austausch zwischen beiden Enden.
Bei der veröffentlichten Rate und Güte dauert ein brauchbares Paar 295 Sekunden. Das Zeitfenster, das es bedienen soll, ist 0,47 Mikrosekunden lang.
Die Planungsgrenze bewegt sich also nicht. Was sich ändert, ist echt, aber etwas anderes: Niemand muss Verschränkung mehr anfordern. Die Versorgung wird autonom.
Autonomie ist nicht dasselbe wie Freiheit von Planung. Sie verschiebt die Grenze dessen, was geplant werden muss — genau dorthin, wo die Rechnung beginnt.
→ Zum Artikel: What Autonomy Actually Removes
 Was der Operator vor dem Partitionierer verbirgt
(im Original: „What the Operator Hides From the Partitioner")
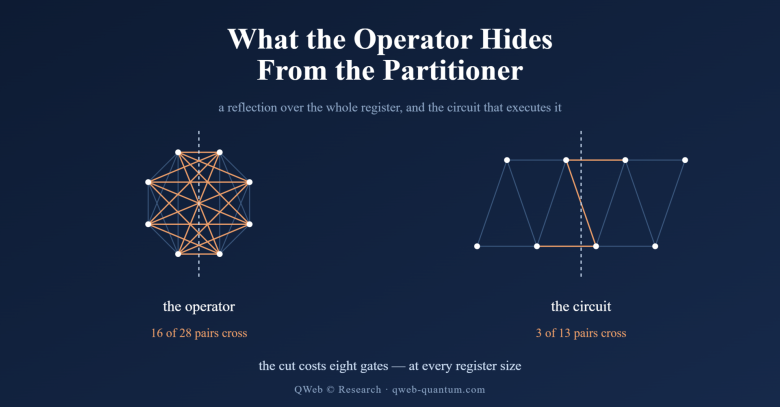
Amplitudenverstärkung — die Verallgemeinerung des Grover-Algorithmus — sieht aus wie der eine Rechenvorgang, den man nicht auf mehrere Maschinen aufteilen kann. Ihr Diffusionsoperator ist eine Spiegelung, an der jedes Qubit des Registers teilnimmt. In einer Maschine aus mehreren Modulen müsste damit jede einzelne Iteration jede Modulgrenze überqueren, und kein noch so guter Partitionierer könnte etwas daran ändern.
Genau das habe ich als Hypothese in einer Entwurfsnotiz festgehalten, datiert, um sie anschließend zu messen. Sie hat etwa zwei Stunden überlebt.
Denn der Operator ist nicht die Schaltung. Wer die Spiegelung tatsächlich ausführen will, schreibt sie als Kette von Toffoli-Gattern über Hilfsqubits — und eine Kette hat einen billigen Schnitt. Gemessen liegt er bei acht Gattern, und zwar bei jeder geprüften Registergröße. Der Graph des Operators ist vollständig, der Graph der Schaltung ist eine Leiter, und wer eine Leiter durchtrennt, erwischt eine einzige Sprosse.
Das Bemerkenswerte daran ist, wofür die Hilfsqubits eigentlich ausgegeben werden: Sie senken die Gatterzahl. Der billige Schnitt fällt dabei ungefragt ab. Die Quanteninformatik hat meine Frage also vor Jahrzehnten beantwortet, ohne sie je gestellt bekommen zu haben.
Der englische Artikel führt die Rechnung vollständig vor — einschließlich der zweiten Messung, in der das registrierte Ziel zurück-genommen werden musste. Die widerlegte Hypothese steht wörtlich und datiert darin. Ein Artikel, der seine eigene Ausgangsthese still austauscht, ist einer, den niemand mehr prüfen kann.
Am Morgen nach der Veröffentlichung hat Daniel Hug (qubit-lab.ch) eine Frage gestellt, die das Gleiche mit meiner Bilanz gemacht hat: Müsste über eine Modulgrenze nicht ein einziger kontrollierter Block genügen, statt jedes kreuzende Gatter einzeln zu bezahlen? Er hatte recht, und der Grund stand von Anfang an da. Die Gleichverteilung ist ein Produktzustand, also zerfällt der Operator über jedem Schnitt in zwei Produktterme — und damit kreuzt genau eine Operation die Grenze, nicht acht. Für Grover über sechzehn Qubits kostet das 201 Ebits statt der 1.608, die ich veröffentlicht hatte. Mein Abschnitt 07 hat das Minimum über Platzierungen einer gegebenen Schaltung gemessen; über eine Modulgrenze zählt das Minimum über Implementierungen des Operators. Der Fehler hat eine Form, die ich im Artikel stehen lasse: Auf einem Chip führt der Operator in die Irre und man lese die Schaltung — über eine Verbindung hinweg ist es genau umgekehrt. Ich habe die zweite Hälfte dieses Fehlers gemacht, während ich über die erste schrieb. Der Korrekturkasten steht datiert im Artikel, mit Daniels Namen daran, und die Messungen zur Kompilierung auf einem Chip sind davon unberührt.
Alle drei Rechnungen, die Entwurfsnotiz und ihre vier datierten Nachträge liegen offen im Repository:
https://github.com/RamonSchweiss/qweb-research
→ Zum Artikel: What the Operator Hides From the Partitioner
 Was der Partitionierer nicht mehr löst
(im Original: „What the Partitioner Stops Solving")
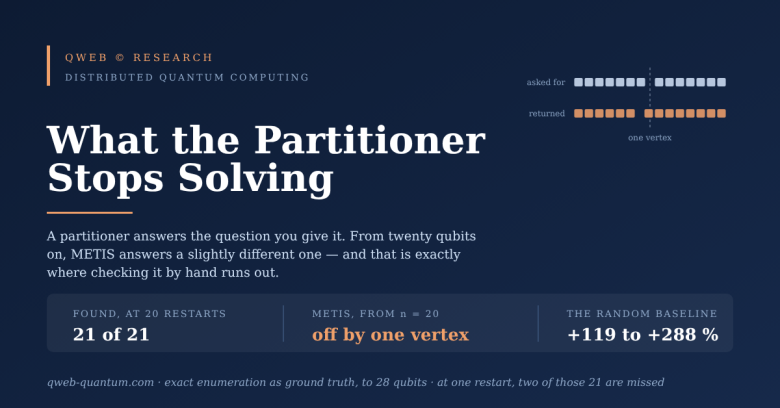
Eine frühere Messung hier sagte: In 21 von 21 Problemgraphen liegt der exakte minimale Gatterschnitt in der letzten Schicht dort, wo er in der ersten lag. Das ist eine Aussage über das Objekt — darüber, wo das Optimum liegt. Sie sagt nichts darüber, ob ein Partitionierer, den jemand tatsächlich laufen lässt, dort auch hinkommt.
Der neue Beitrag misst das nach, gegen exakte Aufzählung jeder balancierten Zweiteilung. Die Antwort ist beruhigend und hat eine Be-dingung: Kernighan–Lin trifft das exakte Optimum in allen 21 Graphen und bei jeder Größe bis 28 Qubits — bei zwanzig Neustarts. Bei einem verfehlt es zweimal. Die Null gehört dem Budget, nicht dem Verfahren.
Zwei Dinge kamen dabei heraus, die nicht die Frage waren.
METIS liefert ab zwanzig Qubits Partitionen, die gar nicht mehr balanciert sind — und zwar um genau einen Knoten, bei jeder Größe. Das ist ein Toleranz-Artefakt und kein Werkzeug, das nicht partitionieren kann. Aber ein Schnitt, der um eins daneben liegt, minimiert über eine größere Menge und ist mit dem balancierten Optimum nicht mehr vergleichbar. Man sieht das der Ausgabe nicht an. Man sieht es nur einem Vergleich an, den die Ausgabe nicht enthält.
Und die Vergleichsbasis, gegen die die Literatur rechnet — eine zufällige balancierte Zuordnung — liegt zwischen 119 und 288 Prozent über dem Optimum, mit wachsendem Abstand. Wer so misst, hat zwei- bis fast vierfachen Spielraum.
Der Schluss schließt mich ein, zweimal: Die zuerst registrierte Frage war leer, und meine eigene beschleunigte Grundwahrheit war beim ersten Einsatz falsch — bei exakt stimmenden Partitionszahlen.
→ Zum Artikel: https://qweb-quantum.com/blog/what-the-partitioner-stops-solving
Quantum Networks (QNT)
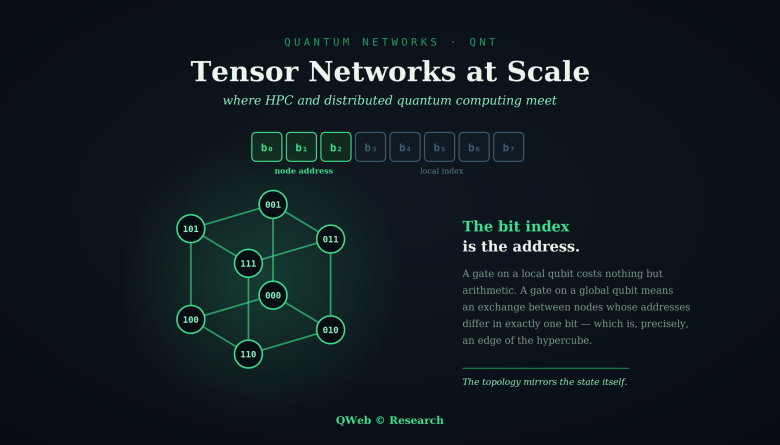 Tensor-Netzwerke im großen Maßstab: Wo HPC und verteiltes Quantencomputing zusammentreffen
(im Original: „Tensor Networks at Scale: How HPC and Distributed Quantum Computing Meet")
Ein Quantenzustand aus 300 Teilchen braucht zu seiner Beschreibung mehr Zahlen, als das beobachtbare Universum Atome hat. Tensor-Netzwerke drücken das auf wenige Millionen — aber auch wenige Millionen Tensoren müssen irgendwo gespeichert, kontrahiert und aufsummiert werden. Dieses „irgendwo" ist eine massiv parallele Maschine. Und genau dort treffen die klassische und die quantenmechanische Seite des Problems tatsächlich aufeinander.
Der Artikel setzt dort an, wo meine deutschsprachige Einführung „Was ist ein Tensor?" aufhört, und verfolgt die Ingenieursseite.
Warum ausgerechnet der Hyperwürfel? Eine Amplitude eines n-Qubit-Zustands trägt eine Adresse aus n Bits. Nimmt man k davon als Knotenadresse, so gilt: Ein Gatter auf einem lokalen Qubit ist reine Lokalrechnung ohne jeden Datenverkehr. Ein Gatter auf einem globalen Qubit dagegen erfordert einen Austausch zwischen Knoten, deren Adressen sich in genau einem Bit unterscheiden — und das ist per Definition eine Kante des Hyperwürfels. Die Topologie ist also kein Implementierungsdetail, sondern spiegelt die Struktur des Zustands selbst. Wer in den 1980er Jahren an paralleler Ablaufsteuerung gearbeitet hat, erkennt die Frage wieder: Wo platziert man Information im Prozessornetz, damit die teuren Transfers minimal bleiben?
Kontraktion ist die eigentliche Arbeit. Der Artikel erklärt das Verfahren des Slicing, mit dem eine einzige riesige Kontraktion in viele unabhängige zerlegt wird, und zwei Befunde, die aus der gewöhnlichen HPC-Welt überraschen: Eine bessere Kontraktionsreihenfolge bringt mehr als eine größere Maschine — mehr als eine Größenordnung. Und in der Cloud scheitert das Verfahren nicht an fehlender Rechenleistung, sondern an der Latenz.
Die Brücke zum verteilten Quantencomputing: Dieselbe Mathematik wird zur Koordinationsschicht zwischen getrennten Quantenprozessoren. Ein zu großer Schaltkreis wird zerschnitten, die Teile laufen auf kleineren QPUs, und die Rekonstruktion des Gesamtergebnisses geschieht als Tensor-Kontraktion. Der klassische Höchstleistungsrechner konkurriert hier nicht mit den Quantenrechnern — er ist das, was mehrere von ihnen wie einen erscheinen lässt.
Die Anwendung, die sich schon heute rechnet: Risikoquantifizierung in Banken und Versicherungen. Monte-Carlo-Simulation konvergiert nur mit 1/√N — eine zusätzliche Dezimalstelle kostet das Hundertfache an Rechenzeit. Tensor-Netzwerke stellen die Verteilung dar, statt sie abzutasten; für die Bewertung von Multi-Asset-Optionen wurden mehrere Größenordnungen Vorsprung berichtet. Crédit Agricole CIB, BBVA und die Bank of Canada haben dazu reale Experimente durchgeführt.
Der entscheidende Punkt wird dabei leicht übersehen: Es handelt sich um quanteninspirierte klassische Algorithmen. Sie laufen heute, auf Hardware, die eine Bank ohnehin besitzt. Kein Kryostat, keine Qubit-Zahl, kein Warten auf Fehlertoleranz.
Und ein Vorteil, der in der Berichterstattung fast nie vorkommt: Ein Matrixproduktzustand liefert interpretierbare Wahrscheinlich-keiten statt undurchsichtiger Gewichte. Für jeden, der schon einmal eine Modellvalidierung miterlebt hat, ist diese Eigenschaft von Bedeutung. Stünden Finanzinstitute vor der Wahl zwischen einem Modell, welches zehnmal schneller läuft, und einem, welches eine Prüfungsinstanz tatsächlich nachvollziehen kann, würden sich viele für Letzteres entscheiden.
→ Zum Artikel: Tensor Networks at Scale
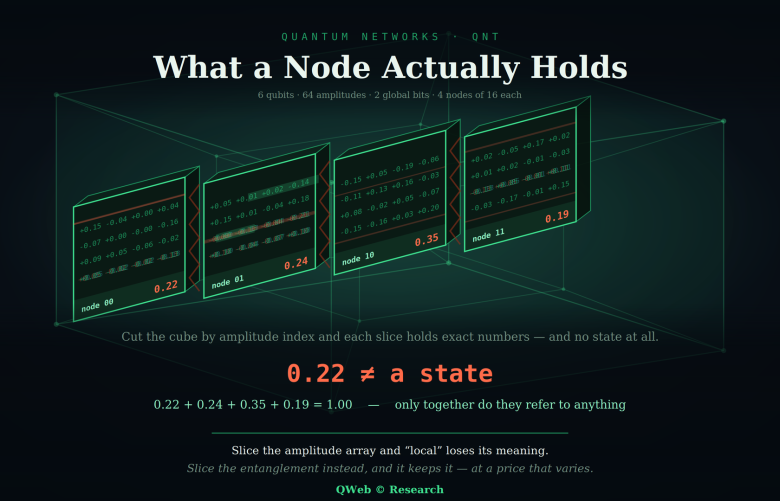 Was ein Knoten tatsächlich enthält
(im Original: „What a Node Actually Holds")
Verteilt man einen Quantenzustand über einen Rechnerverbund, gibt es zwei Arten, ihn zu zerschneiden. Sie sind keine Spielarten derselben Idee — und der Unterschied entscheidet darüber, was das Ganze kostet.
Die erste zerlegt das Amplitudenfeld. Der Qubit-Index wird zur Knotenadresse; ein Gatter auf einem globalen Qubit bedeutet einen Austausch über eine Kante des Hyperwürfels. Das Verfahren funktioniert, und die Rechnung geht auf.
Es hat allerdings eine Folge, die mir erst beim Nachrechnen klar wurde: Ein Knoten hält in diesem Schema überhaupt keinen Zustand. Nicht etwa einen leeren — gar keinen. Um den reduzierten Zustand seiner Qubits zu bilden, müsste über alle anderen Knoten summiert werden.
Im Artikel steht dazu ein Beispiel mit vier Qubits, klein genug, um es vollständig abzudrucken: sechzehn Amplituden als Tabelle, jede Zeile ein Knoten. Die vier quadrierten Zeilennormen ergeben zusammen 1, jedoch keine einzelne für sich. Was ein Knoten allein bilden kann, hat die Spur 0,1969 — also genau seinen eigenen Anteil. Exakte Zahlen, aber ohne physikalischen Bezug.
Die zweite zerlegt die Verschränkung. In einem Tensor-Netzwerk gehört jeder Tensor zu einem Ort, die Bindungen tragen die Korrelation, und „lokal" bedeutet dort, was es sonst auch bedeutet.
Und dann laufen die Kosten auseinander. Der Hyperwürfel bewegt stets dieselben 512 Amplituden — ob der Zustand ein reiner Produktzustand oder vollständig durchmischt ist, spielt keine Rolle. Er ist blind gegenüber Verschränkung, was nicht überrascht, da er sie nie dargestellt hat. Das Tensor-Netzwerk reicht von zwanzig bis zwanzigtausend Zahlen und folgt der Entropie genau. Die beiden Verfahren kreuzen sich bei etwa 1,4 Bit.
Damit ist der Handel ehrlich beschrieben: eine feste Gebühr, die man immer zahlt, gegen eine schwankende, die weit darunter oder weit darüber liegen kann.
Ein Vorzug des Hyperwürfels wird dabei leicht übersehen: Weil er blind gegenüber Verschränkung ist, kann er auch nicht schlecht zu ihr passen. Eine angepasste Struktur ist besser, wenn sie passt, und schlechter, wenn nicht — und man erfährt es erst hinterher. Sie verlangt genau jenes Wissen, das man noch nicht hat.
Der Beitrag schließt mit einer Rückbindung an die Leitfrage dieser Seite. Neben „lokal bestimmt" und „lokal leer" gibt es hier einen dritten Fall: lokal bedeutungslos. Und daraus folgt eine Unterscheidung, die mir wesentlich scheint — ist ein Teil ein Teil des Systems oder nur ein Teil der Beschreibung?
→ Zum Artikel: What a Node Actually Holds
Quantum Security & Cryptography (SEC)
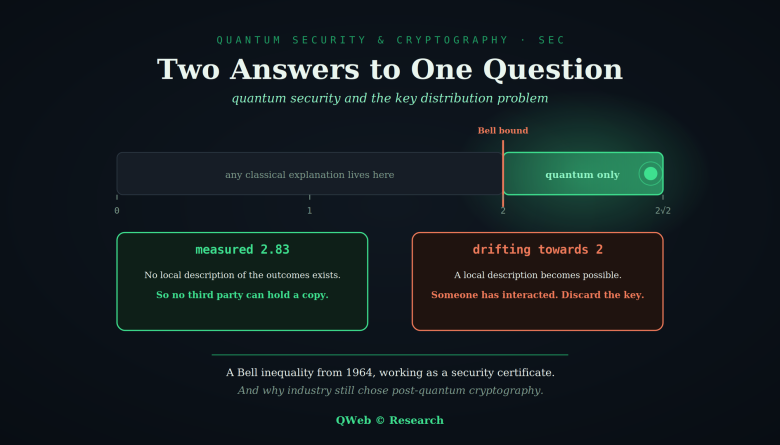 Zwei Antworten auf eine Frage: Quantensicherheit und das Schlüsselverteilungsproblem
(im Original: „Two Answers to One Question: Quantum Security and the Key Distribution Problem")
Hinter dem Begriff „Quantensicherheit" verbergen sich zwei Fragen, und sie haben unterschiedliche Antworten. Die erste lautet wie funktioniert das — und die Antwort ist bemerkenswert. Die zweite lautet was soll mein Haus tun — und diese Antwort ist nüchterner, hat eine Frist, und kommt weitgehend ohne Quantenhardware aus. Der Artikel gibt beide und hält sie sauber auseinander.
Teil I folgt der Physik. Das No-Cloning-Theorem, hier in drei Zeilen bewiesen, ist der Grund, warum ein Lauscher nicht einfach eine Kopie nehmen und das Original unverändert weiterreichen kann. Von dort zu den beiden Wegen der Quantenschlüsselverteilung: BB84 von 1984 kommt ganz ohne Verschränkung aus, E91 von 1991 nutzt sie. Verschränkung ist für QKD also hinreichend, aber nicht notwendig — was die Frage aufwirft, wozu der aufwendigere Weg dann gut ist.
Die Antwort darauf bildet das Herzstück des Artikels: Eine gemessene Bell-Verletzung ist ein Sicherheitszertifikat. Besäße die Lauscherin Eve irgendeine Aufzeichnung über den Schlüssel, dann existierte eine lokale Beschreibung der Messergebnisse — nämlich jene, die ihre Aufzeichnungen einschließt. Und existierte eine solche Beschreibung, könnte der CHSH-Wert nicht über 2 liegen. Ein gemessener Wert nahe 2√2 bezeugt also, dass sie nichts hat. Das nennt man geräteunabhängige Schlüsselverteilung: Man muss dem Hersteller der Geräte nicht vertrauen, sondern nur der Zahl, die sie ausgeben. Eine Kuriosität aus dem Jahr 1964 ist damit zum Betriebsmittel geworden.
Teil II fragt, was daraus folgt — und antwortet anders. „Harvest now, decrypt later" macht die Frist konkret: Heute mitgeschnittene Daten lassen sich später entschlüsseln. Die Rechnung ist einfach: Vertraulichkeitsdauer plus Migrationsdauer, verglichen mit der Ankunft leistungsfähiger Hardware.
Die Industrie hat sich dennoch für Post-Quanten-Kryptografie entschieden und gegen QKD — aus handfesten Gründen. Photonen lassen sich nicht kopieren und deshalb auch nicht verstärken; ausgerechnet das Theorem, das die Sicherheit liefert, verbietet den Repeater, der die Reichweite verlängern würde. Lange Strecken brauchen daher vertrauenswürdige Zwischenknoten — und führen genau die Vertrauensannahme wieder ein, die QKD beseitigen sollte.
Der Artikel nennt die Standards (NIST, 13. August 2024: ML-KEM, ML-DSA, SLH-DSA), die Fristen (US-Verfügung vom Juni 2026: 2030 und 2031) und die konkreten Schritte: Inventur, Priorisierung nach Vertraulichkeitsdauer, hybride Verfahren, Krypto-Agilität.
Und er nennt das ehrliche Gegenargument: PQC könnte fallen. Ihre Sicherheit ruht auf jungen mathematischen Annahmen. SIKE, ein NIST-Kandidat der vierten Runde, wurde 2022 in Polynomialzeit gebrochen — auf einem gewöhnlichen Rechner, in etwa einer Stunde. Physikalische Gesetze dagegen werden nicht kryptanalysiert.
→ Zum Artikel: Two Answers to One Question
Quantum Artificial Intelligence (QAI)
 Die Verschmelzung von KI und Quantencomputing: Quanten-KI (QAI)
(Im Original: The Merge of AI with QC: Quantum AI (QAI))
„KI plus Quantencomputing" mag nach einem einzigen riesigen Supercomputer klingen – doch die Architektur, die sich heute tatsächlich herausbildet, ist subtiler und weitaus interessanter. In aktuellen Forschungssystemen übernehmen die drei Technologien unterschiedliche, sich ergänzende Rollen: KI unterstützt Forscher beim Entwerfen von Experimenten, beim Interpretieren von Ergebnissen, beim Optimieren von Quanten-schaltkreisen und beim Orchestrieren zunehmend komplexer Arbeitsabläufe. Quanten-prozessoren bearbeiten ausgewählte Probleme mit einem grundlegend anderen Rechenmodell. Und klassische Supercomputer leisten weiterhin den Großteil der eigent-lichen Rechenarbeit drumherum.
Das Ergebnis ist ein hybrider Stack: KI für Vorhersage und Automatisierung, GPUs für Simulation und Hochleistungsrechnen, Quantenprozessoren für spezialisierte Experimente. Alle großen Technologieunternehmen investieren in die Software, die diese Ebenen miteinander verbindet – Google mit Cirq und TensorFlow Quantum, Microsoft mit Azure Quantum, Q# und seinem Quantum Development Kit, IBM mit dem Qiskit-Ökosystem für Quantenalgorithmen und Machine-Learning-Forschung sowie NVIDIA mit cuQuantum für beschleunigte Quantensimulation und CUDA-Q für hybride Workflows.
Nichts davon bedeutet, dass Quantencomputer KI-Systeme oder herkömmliche Rechen-zentren in absehbarer Zeit ersetzen werden. Die eigentliche Chance liegt heute im Zu-sammenspiel aller drei Ebenen – KI, klassisches Hochleistungsrechnen und Quanten-hardware. Langfristig könnte diese kombinierte Architektur die Chemiesimulation, die Ma-terialforschung, die Optimierung und die wissenschaftliche Entdeckung voranbringen. Und es könnte sich durchaus herausstellen, dass die Unternehmen, die die verbindende Software bauen, genauso wichtig sind wie jene, die die Quantenprozessoren selbst entwickeln.
→ Zum Artikel: https://qweb-quantum.com/pub-quantum-ai-qai
 Laufen LLMs auf Quantencomputern? Noch nicht – aber es tut sich etwas anderes
Laufen LLMs auf Quantencomputern?
Noch nicht – aber es tut sich etwas anderes
(im Original: „Quantum Computing and Large Language Models: Where We Actually Stand")
Es ist eine weit verbreitete Annahme: Bei all den Schlagzeilen zum Thema Quantencomputing in letzter Zeit müssen Claude oder ChatGPT doch mittlerweile sicherlich auf Quantenhardware laufen, oder? Das tun sie nicht – und die heutigen Quantenprozessoren sind für diese Art von Arbeitslast nicht ausgelegt. Aber zwei weniger beachtete Entwicklungen sind erwähnenswert. Forschern ist es kürzlich gelungen, mit einem echten 156-Qubit-Quantenprozessor von IBM die Genauigkeit eines Llama-Modells messbar zu verbessern – und zwar mithilfe eines winzigen Quanten-Add-ons anstelle des Modells selbst. Unterdessen revanchiert sich die KI: Neue Open-Source-Modelle von Nvidia beschleunigen die Kalibrierung und Fehlerkorrektur von Quantenhardware, und Sprachmodelle wie Claude halfen einem Team dabei, die pro Qubit benötigte Atomanzahl um den Faktor 100 zu reduzieren. Keines davon ist ein Quanten-LLM. Beide sind Schritte in Richtung etwas Interessanterem.
→ Zum Artikel: https://qweb-quantum.com/blog/quantum-ai-llm
Quantum Machine Learning (QML)
 Quantum Machine Learning: Was davon tatsächlich stimmt
(im Original: „Quantum Machine Learning: What Is Actually True")
Vorausschauende Datenanalyse gehört zu den am weitesten verbreiteten Anwendungen der Informationstechnik — und stößt an eine harte Grenze, den sogenannten Fluch der Dimensionalität: Jedes zusätzliche Merkmal fügt dem Suchraum eine Dimension hinzu, und dieser Raum wächst exponentiell. Irgendwann deckt die verfügbare Datenmenge den Raum, in dem sie lebt, nicht mehr ab.
Quantum Machine Learning verspricht eine Antwort darauf: Ein System aus n Qubits spannt einen Zustandsraum von 2ⁿ Dimensionen auf — warum also nicht darin lernen? Der Zustandsraum ist real. Ob er sich nutzen lässt, ist eine andere Frage.
Der Artikel folgt den Belegen. Er beschreibt die zwei Nadelöhre, die einen echten Vorteil bislang so schwer nachweisbar machen: Klassische Daten müssen erst in einen Quantenzustand geladen werden — und dieser Schritt kann mehr kosten, als die erhoffte Beschleunigung einbringt. Und am anderen Ende liefert eine Messung nur gewöhnliche Bits, niemals den ganzen Zustandsraum.
Ein eigener Abschnitt gilt der Dequantisierung: Seit Ewin Tangs Ergebnis von 2018 wurden mehrere behauptete Quantenvorteile durch verbesserte klassische Algorithmen wieder eingeholt. Das liest sich zunächst wie eine Reihe von Niederlagen — tatsächlich ist es ein Schärfungswerkzeug, das zeigt, wo ein Vorteil nicht liegt und wo er plausibel bleibt: in Daten mit echter Quanten- oder algebraischer Struktur, nicht in Tabellenkalkulationen.
Dann der Praxistest: Über fünfzehn große Banken betreiben Quantenforschungsprogramme. Keine einzige setzt ein Quantensystem produktiv ein. Goldman Sachs hat beziffert, was für einen realistischen Anwendungsfall nötig wäre — rund 7.500 logische Qubits. Was heute dagegen tatsächlich Wert liefert, sind quanteninspirierte klassische Algorithmen.
Zwei Fragen behandelt der Artikel, die selten zusammen gestellt werden. Erstens die Energiefrage: Wäre maschinelles Lernen auf Quantenhardware energieeffizienter als in den heutigen Rechenzentren? Die Antwort ist komplizierter als die Schlagzeile. Der Prozessor selbst verbraucht praktisch nichts — aber ihn auf wenige Tausendstel Grad über dem absoluten Nullpunkt zu halten, kostet 15 bis 25 Kilowatt. Ein klassisches Rechenzentrum verwendet rund 80 Prozent seiner Energie fürs Rechnen und kann sich durch bessere Kühlung verbessern. Ein Quantensystem verwendet über 99,99 Prozent für Kühlung und Steuerelektronik — die Kühlung ist dort kein Overhead, sondern die Voraussetzung, und sie lässt sich nicht herunterskalieren.
Zweitens die Architekturfrage: Wenn ein Quantenprozessor nur sekundenweise innerhalb eines langen klassischen Vorgangs aufgerufen wird, trägt er seine Kühllast durchgehend, liefert aber nur kurz Rechenleistung. Damit wird die Auslastung zur entscheidenden Größe — und ein geteilter, verteilter Beschleuniger hat ein völlig anderes Energieprofil als einer, der im Keller einer einzelnen Organisation leerläuft. Genau dort schließt sich der Kreis zur QWeb-Architektur.
Fazit: Nicht, dass an Quantum Machine Learning nichts dran wäre – nur liegt das Spannende woanders, als die Werbebotschaften glauben machen wollen.
→ Zum Artikel: Quantum Machine Learning: What Is Actually True
 Die Schicht, die niemand trainiert
(im Original: „The Layer That Nobody Trains")
Hybride Quanten-Neuronale Netze enden mit einem Schritt: klassische und quantenseitige Parameter werden gemeinsam angepasst. Genau dieser Schritt macht das Modell überhaupt erst hybrid — und genau ihn haben mehrere Gruppen stillschweigend aufgegeben. Die Begründung ist nüchtern: Die Quantenparameter bewegen sich beim Training kaum, also werden sie zufällig gesetzt und eingefroren.
Statt das zu glauben, habe ich es nachgemessen. Vier Qubits, fünfundzwanzig Läufe je Variante, fünffache Kreuzvalidierung, abgeglichene Parameterzahl. Der Versuch dauert vier Minuten.
Das erste Ergebnis widersprach dem, was ich in den Arbeiten über hybride Quanten-Neuronale Netze gelesen hatte. Bei festem Encoder kostete das Einfrieren der Quantenschicht 19,5 Prozentpunkte — das Gegenteil dessen, was dort berichtet wird.
Also habe ich nach dem Unterschied gesucht und ihn gefunden. In den veröffentlichten Arbeiten ist der klassische Teil groß — ein Faltungsnetz mit Hunderten von Parametern, die Quantenschicht trägt wenige Prozent. Mein Aufbau hatte diese Kapazität weggenommen, sodass die Schaltung die Arbeit allein leisten musste.
Eine Messreihe über die klassische Kapazität klärte es. Stellt man vor und hinter die Schaltung je eine trainierbare klassische Schicht, fällt der Preis des Einfrierens unter einen halben Prozentpunkt. Bei fünfundvierzig klassischen Parametern ist es sogar leicht besser, einzufrieren.
Und weil ein Datensatz eben nur ein Datensatz ist, habe ich das Ganze auf zwei weiteren wiederholt: eine Weinklassifikation mit 130 Proben und 13 Merkmalen, und handgeschriebene Dreien gegen Achten mit 357 Proben und 64 Merkmalen. Andere Fachgebiete, andere Größen, nichts gemeinsam mit dem ersten außer dem Verfahren.
Das Muster hielt jedes Mal — und sogar deutlicher als beim ersten. Ohne klassische Unterstützung braucht die Schaltung ihr Training dringend: 19,6, 27,7 und 30,6 Prozentpunkte, durchweg hochsignifikant. Mit klassischen Schichten daneben wird das Training wertlos: −0,29, +0,47 und +2,56 Punkte, in keinem Fall signifikant.
Beide Befunde gelten. Sie beantworten verschiedene Fragen. Und die ehrliche Aussage ist enger als jede der beiden: Ob die Quantenschicht Training braucht, hängt davon ab, wie viel klassische Maschinerie daneben steht.
Und noch etwas, womit ich nicht gerechnet hatte. Ersetzt man die eingefrorene Schaltung durch eine schlichte zufällige Projektion derselben Breite, gewinnt die Zufallsprojektion um achtzehn Punkte. Die feste Quantenschaltung wirkt also nicht bloß wie eine zufällige Merkmalsabbildung — bei dieser Größe ist sie eine ziemlich schlechte.
Die Gradienten verschwinden übrigens nicht. Sie liegen bei 0,016 und steigen im Verlauf sogar an. Bei vier Qubits mit lokalen Observablen gibt es hier kein barren plateau — ein Phänomen der Quanten-Optimierung, bei dem die Gradienten der Verlustfunktion mit zunehmender Qubit-Zahl exponentiell gegen null gehen. Die mathematische Landschaft, in der der klassische Optimierer nach den besten Parametern sucht, wird dann praktisch flach, und ein Optimierer auf flachem Gelände hat nichts, wohin er absteigen könnte. Es ist das quantenmechanische Gegenstück zum Problem der verschwindenden Gradienten im klassischen tiefen Lernen (deep learning) — andere Ursache, gleiches Erscheinungsbild, gleiche Folge: Das Training funktioniert nicht mehr, und Geduld hilft nicht.
Dass hier kein solches Plateau auftrat, ist erwähnenswert, weil es die gängigste Erklärung dafür entkräftet, warum die Quantenparameter sich angeblich nicht bewegen.
Was das für die hybride Idee bedeutet. Nicht widerlegt, sondern unbelegt in jenem Bereich, in dem sie üblicherweise gebaut wird. Die Vorbehalte bleiben, und ich möchte sie festhalten: durchgehend vier Qubits, ein Schaltungsentwurf, eine Encoder-Familie, drei kleine Datensätze. Das ist kein allgemeines Ergebnis über Quantum Machine Learning (QML). Was es ist: eine Messung, wo zuvor eine Literaturstelle stand — mit offenem Code für jeden, der sie widerlegen möchte.
→ Zum Artikel: The Layer That Nobody Trains
→ Zum Code: github.com/RamonSchweiss/qweb-research
QWeb © Architecture (QWB)
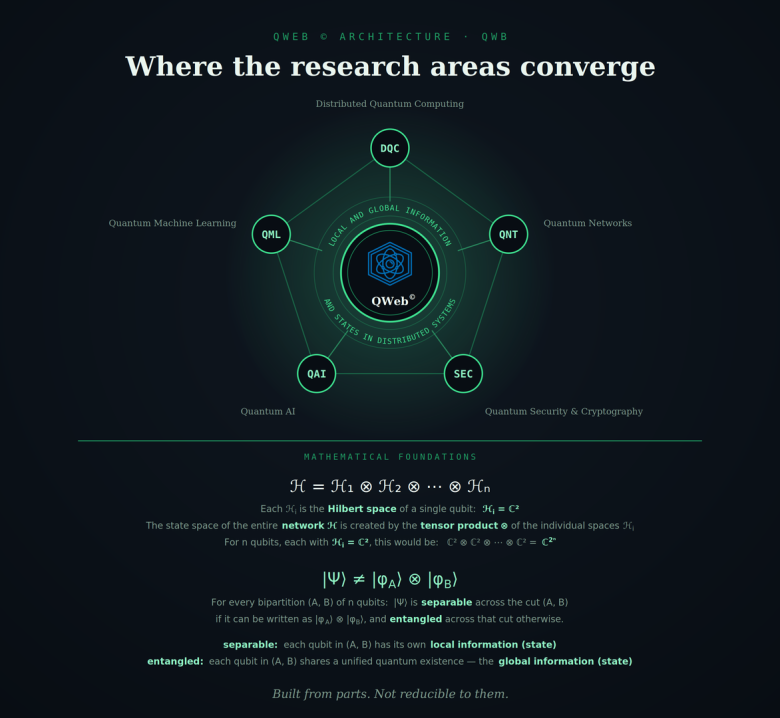 Wo die vorangehenden Forschungsbereiche zur QWeb © Architektur zusammenlaufen
(im Original: „Where the Research Areas Converge")
Auf QWeb © Research (www.qweb-quantum.com) sind Beiträge zu fünf Forschungsbereichen entstanden — zur Geometrie der Verschränkung, zu Tensor-Netzwerken auf Höchstleistungsrechnern, zur Frage, was Quantensicherheit leistet und was nicht. Jeder Bereich mit seiner eigenen Fragestellung.
Der neue Abschnitt ist der Ort, an dem sie zusammenlaufen. Und er beginnt dort, wo jede Architektur beginnen muss: bei der Mathematik, die sagt, was ein verteiltes Quantensystem eigentlich ist.
Zwei Formeln tragen die gesamte Argumentation.
Die erste beschreibt den Aufbau: Der Zustandsraum des Netzes entsteht als Tensorprodukt der Räume seiner Knoten. Jeder Knoten bringt seinen eigenen Hilbertraum ein — bei einem Qubit schlicht ℂ2 —, und das Ganze wächst dabei nicht additiv, sondern multiplikativ auf die Dimension 2n.
Die zweite beschreibt die Grenze dieses Aufbaus: Zerlegt man das Netz in zwei Gruppen A und B, so lässt sich fragen, ob der Gesamtzustand als Produkt zweier Gruppenzustände darstellbar ist. Gelingt das, sind die Gruppen unabhängig voneinander beschreibbar — lokale Information und Zustände. Gelingt es nicht, dann ist der Zustand über diesen Schnitt hinweg verschränkt: Kein Teil besitzt dann noch einen eigenen, für sich beschreibbaren Zustand, und die Gruppen teilen sich eine gemeinsame Existenz — globale Information und Zustände.
Aus Teilen aufgebaut. Nicht auf sie zurückführbar.
Auf diesen beiden Zeilen ruht alles Weitere: warum Verteilung die natürliche Bauform für Quantencomputing ist, warum die Verbindungsstruktur wichtiger wiegt als der einzelne Prozessor, und warum Verschränkung eine Ressource ist, die man verteilen und lenken muss — und nicht bloß ein Phänomen, das man bestaunt.
Inzwischen ist der Abschnitt gewachsen. Fünf Stränge führen die These aus — die Verschränkungsentropie als abrechenbare Größe, ein Verfahren aus der Graphentheorie zur Frage, wo ein Quantennetz geteilt werden sollte, und der Lernmechanismus, der diese Entscheidung nachführt, während sich der Zustand ändert. Und er schließt mit einem Ergebnis: Verschränkung E und lokale Konsistenz C sind für reine Zustände exakt komplementär, ihre Summe ist eins. Bei Rauschen gilt nur noch E + C ≤ 1. Die Lücke ist klassische Unsicherheit — Information, die lokal fehlt, ohne in der Korrelation aufzutauchen. In einem verrauschten Netz geht Konsistenz verloren, ohne dass jemand davon profitiert.
Bemerkenswert dabei: Die Leitfrage stammt aus meiner Diplomarbeit von 1986 — „Lokale und globale Information in verteilten Systemen". Damals ging es um Prozessornetze, heute um Quantenknoten. Die Frage ist dieselbe geblieben.
Und damit schließt sich der Kreis auf unerwartete Weise. Damals lautete die Antwort: Die Konsistenz zwischen lokaler und globaler Information ist durch die Lichtgeschwindigkeit begrenzt. In der Quantenmechanik ist sie ebenfalls begrenzt — aber durch die Verschränkungsentropie. Die klassische Schranke ist zeitlich: Die Information existiert, sie ist nur noch nicht hier, und Warten hilft. Die Quantenschranke ist strukturell: Die Information existiert lokal überhaupt nicht, und kein Warten erzeugt sie. Die Frage von 1986 wurde nicht anders beantwortet — sie wurde zweimal beantwortet.
Inzwischen ist aus dem Fundament eine ausgeführte Argumentation geworden — und an einer Stelle hat sie sich selbst korrigiert.
Der fünfte Strang endet mit einer Rechnung zur zentralen Ablaufplanung. Die daraus abgeleitete Entfernungsgrenze beruhte auf einer Annahme darüber, wie lange die Partitionsgewichte brauchbar bleiben — irgendwo zwischen fünfzig und tausend Gatteroperationen. Diese Annahme ist inzwischen gemessen. Der Horizont liegt bei etwa fünfzehn Gattern und damit unterhalb der angenommenen Spanne. Er hängt stark von der Struktur des Problemgraphen ab: Bei gleicher Qubit- und Kantenzahl liegt zwischen einem zufälligen Interaktionsgraphen und einer stark strukturierten Familie ein Faktor siebzehn in der Lebensdauer einer Aufteilung — etwa acht nebenläufige Gatterrunden im einen Fall, etwa hundertzehn im anderen.
Die Entfernungsangaben, die ich daraus abgeleitet hatte — rund siebzig Meter bei zufälligen Graphen, bis zu etwa einem Kilometer bei strukturierten, zuvor zwei Kilometer — nehme ich zurück. Sie setzten voraus, dass die Latenz einer Planungsentscheidung kleiner sein muss als dieser Horizont. Genau diese Ungleichung hat das anschließende Messprogramm widerlegt. Wo die Schaltung zur Übersetzungszeit bekannt ist, entscheidet die Gatterstruktur über den Schnitt, und der Schnitt wandert nicht. Wo sich die Struktur unangekündigt ändert, hat das Alter der Information genau einen operativen Nutzen: Es sagt einem Planer, wann er seine gegenwärtige Aufteilung noch nicht ändern sollte. Eine Bremse, keine Lenkung.
Was bleibt, ist der Horizont selbst — dass es ihn gibt, dass er messbar ist und dass er von der Struktur abhängt. Was nicht bleibt, ist seine Umrechnung in eine Entfernung. Alle Rechnungen dazu liegen offen: github.com/RamonSchweiss/qweb-research
Die vollständige Darstellung, einschließlich der Rücknahme, steht in What the Computation Knows About Its Own Organisation, geschrieben zusammen mit Venkateswaran Ramamurthy.
→ Zum Artikel: Where the Research Areas Converge
 Was die Rechnung ueber ihre eigene Organisation weiß
Was die Rechnung über ihre eigene Organisation weiß
(im Original: „What the Computation Knows About Its Own Organisation")
Eine veröffentlichte Planungsgrenze, so lange gemessen, bis sie zerbrach — und was danach stehen blieb. Gemeinsam mit Venkateswaran Ramamurthy, Krea University, Indien.
Dieser Artikel berichtet ein Scheitern und die kleine Sache, die es überlebt hat. Das Scheitern ist meines.
Ich hatte auf qweb-quantum.com eine Planungsgrenze veröffentlicht: Eine Rechnung, die über mehrere Prozessoren verteilt läuft, muss aufgeteilt werden, und jedes Zwei-Qubit- Gatter, dessen Enden auf verschiedenen Prozessoren sitzen, kostet ein verschränktes Paar. Die beste Aufteilung, so das Argument, hängt davon ab, wie die Information in der Rechnung verteilt ist — und das ändert sich, während die Rechnung läuft. Eine Aufteilung hat also eine Lebensdauer. Wer weiter weg plant als diese Lebensdauer erlaubt, schickt seine Entscheidung an eine Rechnung, die es nicht mehr gibt. Ich habe Zahlen daraus gemacht: siebzig Meter bis etwa ein Kilometer.
Gemeinsam mit Venkateswaran Ramamurthy von der Krea University in Indien habe ich diese Annahme über mehrere Wochen gemessen. Er stellte die Fragen, ich schrieb die Skripte, und die Abbruchregel stand vorher fest. Acht Skripte, drei Schaltungsfamilien, fünf Planer und ein Optimum mit vollem Rückblick später steht das Ergebnis in drei Klassen.
Ist die Schaltung zur Übersetzungszeit bekannt, wandert die Aufteilung nie. In einundzwanzig von einundzwanzig Graphen ist der beste Schnitt der ersten Schicht auch der beste der letzten. Die Gatterstruktur entscheidet, und wer stattdessen dem Quantenzustand folgt, zahlt zweiundzwanzig Prozent mehr entfernte Gatter.
Nachtrag vom 21. Oktober 2026: Das gilt für den geschriebenen Interaktionsgraphen, auf dem es gemessen wurde. Was das Routing auf Hardware damit macht, ist inzwischen gemessen: Wird jede Schicht einzeln als Block geroutet, wandert der Schnitt in knapp der Hälfte der Fälle mit nichttrivialer Periode, auf einem Quadratgitter in mehr als zwei Dritteln. Der Artikel trägt dazu einen datierten Kasten; Design-Notiz, Nachträge und Ausdrücke liegen im Repository github.com/RamonSchweiss/qweb-research/tree/main/designs.
Ändert sich die Struktur und wird die Änderung angekündigt, schlägt ein einziges klassisches Bit jede Schätzung aus dem Zustand.
Driftet die Struktur unangekündigt, hat die Information genau einen operativen Nutzen — und es ist nicht die Wahl des Schnitts. Sie sagt einem Planer, wann seine gegenwärtige Aufteilung noch nicht umzubauen ist. Eine Bremse, keine Lenkung.
Damit nehme ich die Entfernungsangaben zurück und die Ungleichung dazu. Den Horizont selbst nicht: Es gibt ihn, er ist messbar, und er hängt stark von der Struktur des Problemgraphen ab. Nur seine Umrechnung in Meter hielt nicht.
Venkats Satz für das, was übrig bleibt: Information diszipliniert, wann die Währung ausgegeben wird.
Alle Rechnungen liegen offen im Repository github.com/RamonSchweiss/qweb-research. Wenn eine davon dem Artikel widerspricht, ist der Artikel falsch, und ich möchte es wissen.
→ Zum Artikel: What the Computation Knows About Its Own Organisation
 Was der Stapel noch nicht verbirgt
(im Original: „What the Stack Does Not Yet Hide ")
Die Leistung der Parallelrechner-Jahre war keine einzelne Programmiersprache. Sie war die Einsicht, dass eine Schichtgrenze ein Vertrag ist — und dass ein Vertrag nur dann etwas wert ist, wenn zwei Dinge für ihn gelten: Irgendetwas muss ihn prüfen, und er darf sich nicht ändern, während niemand hinsieht. Niklaus Wirths Module in Modula-2 sind das saubere Beispiel für das Erste, Tony Hoares Kanäle in Occam das für das Zweite. Modula-2 ist dabei nur ein Beispiel von vielen: C mit MPI und OpenMP, Fortran, Go, Rust, Erlang, Haskell, CUDA, OpenCL, X10, Chapel, Unified Parallel C — der klassische Zoo hat vier Grundmuster hervorgebracht, und alle vier tauchen im Quantenstapel wieder auf.
Zwischen einem Quantenprogramm und der Hardware liegen heute vier Schichten: Sprache, Compiler, Zwischendarstellung, Laufzeitumgebung. Alle vier existieren, in mehreren gibt es ernsthafte Produkte, und einige davon sind gut. Mich hat die engere Frage interessiert, nämlich die, an der sich damals entschied, ob Parallelrechner auch für Leute brauchbar wurden, die sie nicht gebaut hatten:
Hält jede dieser Grenzen? Eine Grenze hält, wenn man das darunter austauschen kann, ohne das darüber neu zu schreiben.
Von den Grenzen im heutigen Quantenstapel hält eine. Quantinuums Sprache Guppy behandelt ein Qubit als linearen Typ: Es kann nicht kopiert und nicht stillschweigend verworfen werden. Drei Dinge werden damit zu Übersetzungsfehlern statt zu Laufzeitunsinn — und das No-Cloning-Theorem, das man üblicherweise als Tatsache über die Natur lernt, wird zu einem Typfehler. Die eine Stelle im Stapel, an der ein Compiler eine physikalische Garantie gibt, verdankt sie einer aus Rust entlehnten Idee, Vokabular inklusive.
Die übrigen Grenzen halten nicht, und zwar jede auf ihre eigene Weise. OpenQASM hat ein funktionierendes Gremium mit gewählten Sitzen und beschreibt eine Maschine, die niemand ausliefert: Schleifen und Blöcke stehen in der Spezifikation und laufen nicht auf IBM-Hardware. Der Compiler liest die Tagesform des Geräts mit — vier Durchläufe des Qiskit-Transpilers greifen auf die aktuellen Fehlerwerte zu, und IBMs eigene Dokumentation sagt, es gebe keinen festen Zeitpunkt, zu dem Kalibrierungen beginnen oder enden. Wie viel das schadet, ist offen: Drei Messungen widersprechen sich darin, und die Zusammenführung in meinem Artikel ist meine eigene, nicht die einer der Arbeiten.
Die Pulsebene wurde nicht abstrahiert, sondern gelöscht. Und oberhalb des Compilers beschreiben keine zwei Hersteller mit übersetzbaren Worten, was eigentlich entscheidet, wann ein Programm läuft.
Am längsten beschäftigt mich ein Befund aus Delft. QNodeOS hat die Teile, die ein Betriebssystem hat, und berichtet eine Grenze, die kein besseres Programm beseitigen wird: Sein Scheduler verdrängt nicht, denn einen Quantenprozess zu unterbrechen hieße, einen fragilen Quantenzustand abzulegen, während etwas anderes läuft. Verdrängung ist der Mechanismus, auf dem klassisches Multitasking ruht. Hier verbietet ihn die Physik. Die Liste dessen, was ein Quantenbetriebssystem leisten kann, ist kürzer als die klassische Liste, und der Unterschied ist keine Lücke im Fahrplan.
Der Artikel enthält keine eigenen Messungen. Er ist eine Lesart fremder Dokumentation und fremder Ergebnisse, und die Quellen sind genannt, damit man die Lesart gegen sie prüfen kann. Jede der sechs Aussagen ließe sich mit einem einzigen Gegenbeispiel aus einem ausgelieferten Produkt widerlegen. Wenn eine davon falsch ist, möchte ich es wissen.
→ Zum Artikel: https://qweb-quantum.com/blog/what-the-stack-does-not-hide
 Was ein Decoder voraussetzt
(im Original: „What a Decoder Assumes")
Fehlerkorrektur wird gewöhnlich als Verfahren beschrieben. Man misst die Stabilisatoren, übergibt das Syndrom einem Decoder und wendet die Korrektur an, die er zurückgibt. Die Decoder tragen Namen — Minimum-Weight Perfect Matching, Belief Propagation, inzwischen auch neuronale Netze —, und nach diesen Namen sind die Arbeiten benannt.
Nur kann kein Decoder allein aus dem Syndrom arbeiten. Er muss wissen, welche Fehler überhaupt wahrscheinlich waren, und dieses Wissen ist kein Satz der Mathematik. Es ist eine Liste von Wahrscheinlichkeiten, eine für jede Art, auf die die Maschine danebengehen kann — gemessen an einem Chip, an einem Tag. Das Verfahren ist ein Theorem. Die Liste ist eine Fotografie.
Von den vier üblichen Wegen, an diese Liste zu kommen, lesen drei das Gerät aus: aus den Korrelationen im Syndromverlauf, aus einer Politiksuche auf kleinen Sensorcodes, oder indem man die Kalibrierungsdaten dem Decoder gleich als Eingabe gibt. Nur der vierte, das Lehrbuchmodell, liest gar nichts — und ist überall dort falsch, wo das Gerät nicht gleichförmig ist, also überall.
Was eine falsche Liste kostet, ist veröffentlicht. In der Simulation kostet ein Faktor zehn daneben einen Matching-Decoder im Mittel das 3,6-fache der logischen Fehlerrate, im schlimmsten Einzelfall das 1582-fache. Was eine frische Liste kostet, ist ebenfalls veröffentlicht: etwa eine Million Durchläufe, rein klassische Arbeit, kein einziges zusätzliches Qubit. Und das Zeitbudget, das beides innerhalb der Decodierschleife verbietet, ist veröffentlicht und hart: etwa eine Mikrosekunde je Syndromrunde.
Damit bleibt die Frage, um die es mir ging: Wie schnell hört eine richtige Liste auf, richtig zu sein? Dazu gibt es zwei Messungen an echter Hardware. Sie stammen aus demselben Labor, und sie widersprechen sich.
Die erste ist ein einziger Satz. Über etwa fünfzehn Stunden, mit Rekalibrierung nach je vier Läufen, lagen die logischen Fehlerraten direkt nach einer Rekalibrierung „nicht nennenswert niedriger als unmittelbar davor". Die zweite sagt das Gegenteil: Dort wurde Drift absichtlich eingespeist, und laufendes Nachführen der Steuerung senkte die Fehlerrate um 24 Prozent und machte sie 2,4-mal ruhiger — nahm man die Gewichte des Decoders in dieselbe Schleife auf, wurden daraus 31 Prozent und das 3,5-fache.
Der Unterschied liegt nicht im Ergebnis, sondern im Versuchsaufbau. Eingespeiste Drift ist Drift, von der man weiß, dass es sie gibt, mit einer Rate, die man selbst gewählt hat. Sie zeigt, dass ein veraltetes Modell etwas kostet, wenn sich die Maschine bewegt. Sie sagt nicht, wie schnell sich eine echte Maschine bewegt.
Eine Bemerkung zum Entstehen: Dieser Artikel stand mit einer stärkeren Behauptung fertig da — es gebe überhaupt keine solche Messung. Die Gegenprüfung hat die Arbeit gefunden, die das widerlegt. Der Artikel ist dadurch besser geworden, und ich halte das für den interessanteren Ausgang.
Der Artikel enthält keine eigenen Messungen. Er ist eine Lesart fremder Ergebnisse, und die Quellen sind genannt, damit man die Lesart gegen sie prüfen kann.
→ Zum Artikel: https://qweb-quantum.com/blog/what-a-decoder-assumes
QWeb © Methodology (QME)
 Was ein Verdikt voraussetzt
(im Original: „What a Verdict Assumes")
Messungen werden kalibriert. Schwellen werden begründet, Fehlerbalken gedruckt. Aber „die Differenz ist nicht auflösbar" oder „klas-sisches Territorium" kommt in einem Bericht an wie eine Schlussfolgerung — und ist in Wahrheit beides, Schluss und Messwert. Die zweite Hälfte prüft niemand.
Der neue Beitrag führt das an einem fremden Fall vor und an acht eigenen. Der fremde stammt aus Daniel Hugs Kernel-Studie: Eine Checkliste meldete auf 83 von 84 Datensätzen dasselbe Ergebnis — nicht nur falsch, sondern konstant, und eine konstante Antwort trägt überhaupt keine Information. Dasselbe Instrument lieferte darunter eine stetige Größe, die die Fälle die ganze Zeit kor-rekt ordnete. Das Verdikt ist gescheitert, die Messung nicht.
Die acht eigenen sind in zehn Tagen entstanden, und sie haben alle dieselbe unangenehme Eigenschaft: jeder einzelne Defekt lief zu meinen Gunsten. Das ist kein Zufall. Ein Fehler, der gegen einen läuft, fällt sofort auf, weil das Ergebnis enttäuscht. Einer, der für einen läuft, wird zur Entdeckung.
Sechs der acht hat eine Regel gefangen, die vor dem Lauf dastand. Einer fiel auf, weil eine Zahl nicht passte. Und einen fand ein Le-ser, einen Tag nach der Veröffentlichung — gegen diese Form hilft keine Regel, denn es gibt keine Abbruchbedingung gegen „Du hast nicht nachgesehen".
Dazu eine Tabelle mit fünf Formen, in die alle acht Fälle zerfallen, und vier Dinge, die seitdem anders laufen.
→ Zum Artikel: https://qweb-quantum.com/blog/what-a-verdict-assumes
 Was die Vergleichsbasis bewegt
(im Original: „What Moves the Baseline“)
„Besser als die besten klassischen Verfahren.“ Der Satz steht in jeder Ankündigung und in jedem Lehrbuchkapitel, und er sieht aus wie eine Prüfung. Er ist keine, solange vier Dinge nicht gesagt sind: welches klassische Verfahren, von wem optimiert, auf welcher Instanz, in welchem Zeitbudget und über wie viele Wiederholungen.
Der neue Beitrag geht einen Schritt weiter. Ein Vergleich hat zwei Seiten, und beide bewegen sich — und in den am besten belegten Fällen ist die Quantenbehauptung selbst das, was die klassische Seite bewegt hat. Ewin Tang schreibt in ihrer Einleitung, dass ihr klassischer Algorithmus aus gescheiterten Versuchen entstand, den Quantenvorteil zu beweisen. Nicht aus dem Wunsch, ihn zu schlagen. Die Behauptung hat die Aufgabe gestellt, an der sie zerging.
Dazu ein zweiter Fall mit demselben Muster, ein dritter, der in dieser Debatte ständig als Beleg zitiert wird und bei genauem Hinsehen nicht trägt — und ein gemessener Fall, in dem gleich zwei Modellierungsentscheidungen den Übergangspunkt verschieben, von denen keine in einer Ergebniszusammenfassung vorkommt. Die eine bewegt ihn um bis zum Vierfachen, und nicht einmal in eine Richtung. Die andere um genau den Betrag, den die Amplitude vorhersagt — nur ist diese Bewegung bei 400 Wiederholungen gar nicht aufgelöst. Mein eigener Beitrag ist die schmalere Frage: auf welcher Seite des Vergleichs die Bewegung sitzt.
Der Schluss schließt mich ein, und zwar zweimal. Die kausale Hälfte dieser These habe ich an einem Vormittag öffentlich behauptet und am Nachmittag geprüft; sie hat gehalten, was nicht dasselbe ist wie begründet gewesen zu sein. Und einen Tag nach dem Erscheinen musste der Artikel korrigiert werden — ich hatte zwei Modellierungsentscheidungen zu einer verschmolzen. Korrigiert hat es derjenige, dessen Messung darin vorkommt. Der Fehler saß nicht in der Rechnung; die hatte beide auseinander. Er saß in meinem Lesen der Rechnung.
→ Zum Artikel: https://qweb-quantum.com/blog/what-moves-the-baseline
 Druckversion
